Static Analysis: ensure (or get close to) soundness, while making good trade-offs between analysis precision and analysis speed.
Soundness & Completeness
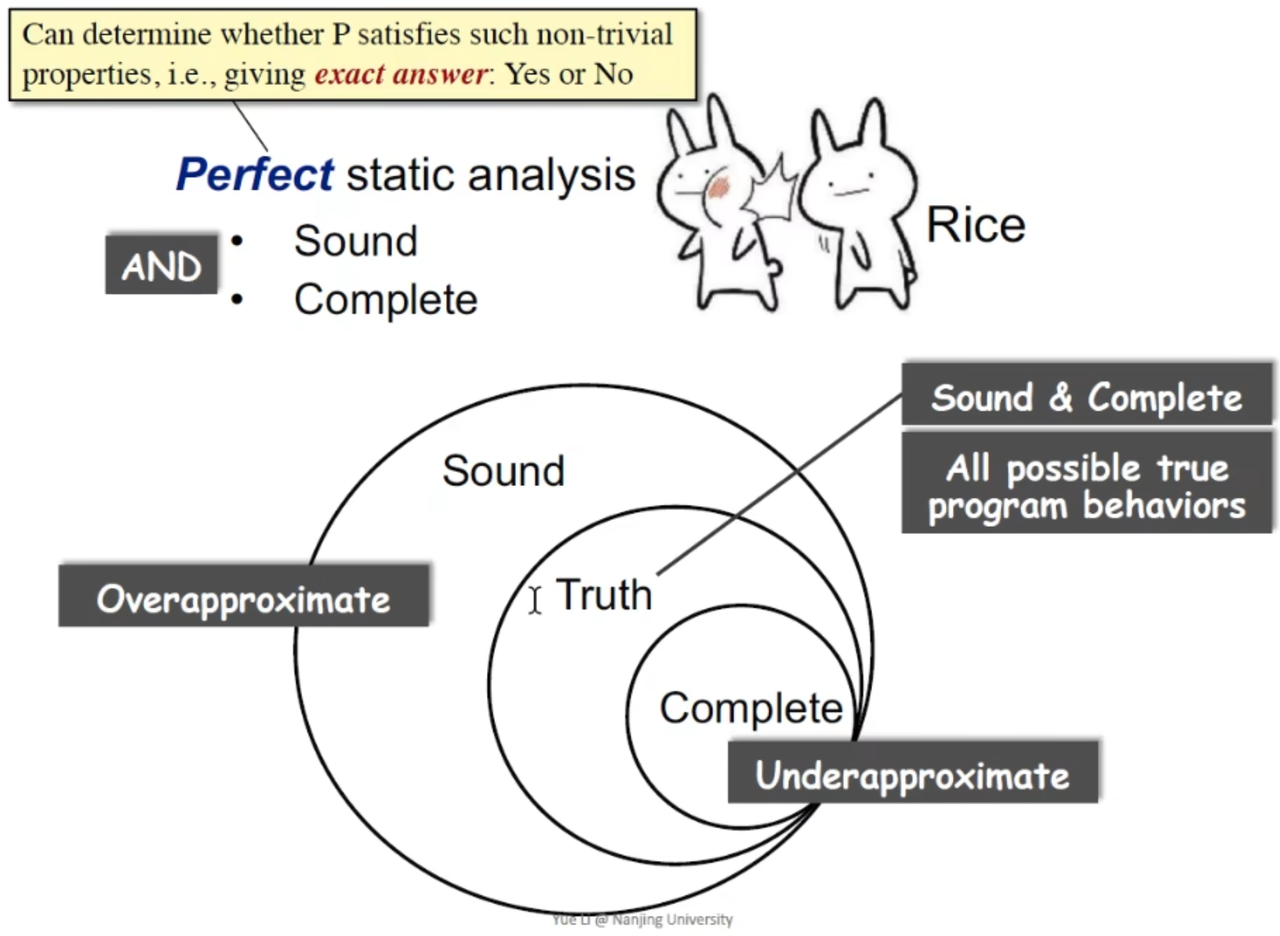
术语 Soundness(可靠性) 来自于形式逻辑和数理逻辑,如果一个证明系统 𝐿 所能证明的语句在该模型中确实为真,那么它就是可靠的。
相对的,如果关于模型为真的任意语句,都能被 𝐿 所证明,那么它就是完备的 (complete) 的。
听起来有点绕,用通俗的说法来说:Soundness 意味着系统“宁错杀不放过”,宁错报不漏报(over-approximate)。而 Completeness 则相反,意味着系统保证报的都是正确的,但会漏报(under-approximate)。
这个世界上不存在既 sound 又 complete 的系统,所以一般优先保证 sound,再在准确性和速度间做取舍。
Data Flow Analysis - Applications
May/Must Analysis
may analysis: outputs information that may be true (over-approximation)
must analysis: outputs information that must be true (under-approximation)
注意,这里不能跟 sound 和 complete 混淆了,数据流分析始终优先确保 sound,无论是 may analysis 还是 must analysis。只是对于这它们来说 soundness 有各自的含义:
may analysis 的 sound:如果事实是“可能”,绝不能报“不可能”。
must analysis 的 sound:如果事实是“不一定”,绝不能报“一定”。
Input & Output States
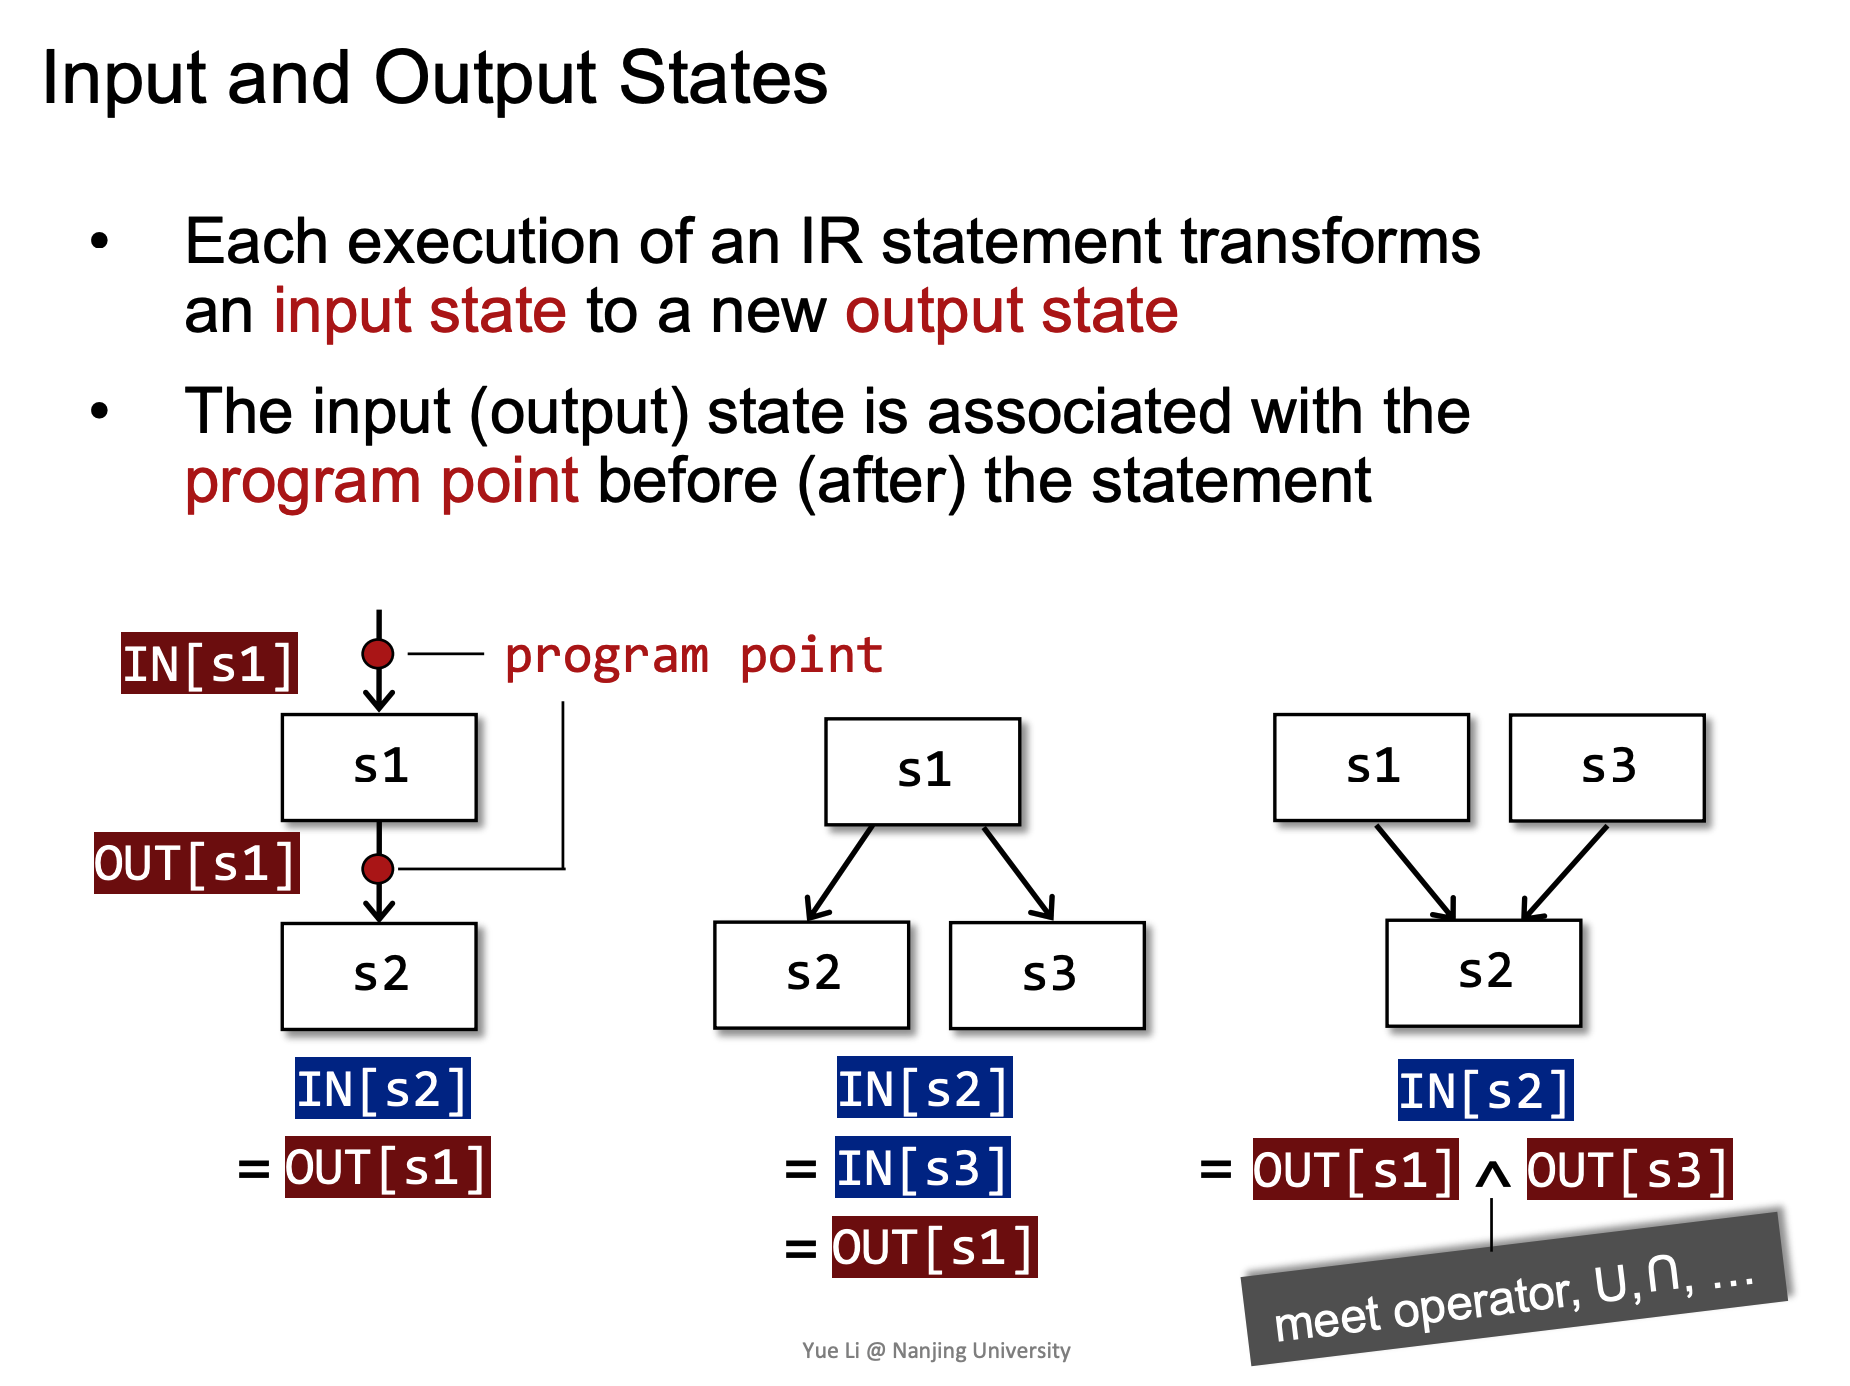
CFG 中每个节点都有一个 IN state 和 OUT state,代表它们的输入输出。
在两个输出交汇时,需要有某种方法将其进行合并作为它们的后继(successor)节点的输入。对于 may analysis 和 must analysis 它们是不一样的,将其抽象为 meet operator (^)。
may analysis 的 meet operator 是取并集(union),must analysis 的 meet operator 则是取交集(interset)。
Forward Anaysis & Backward Anaysis
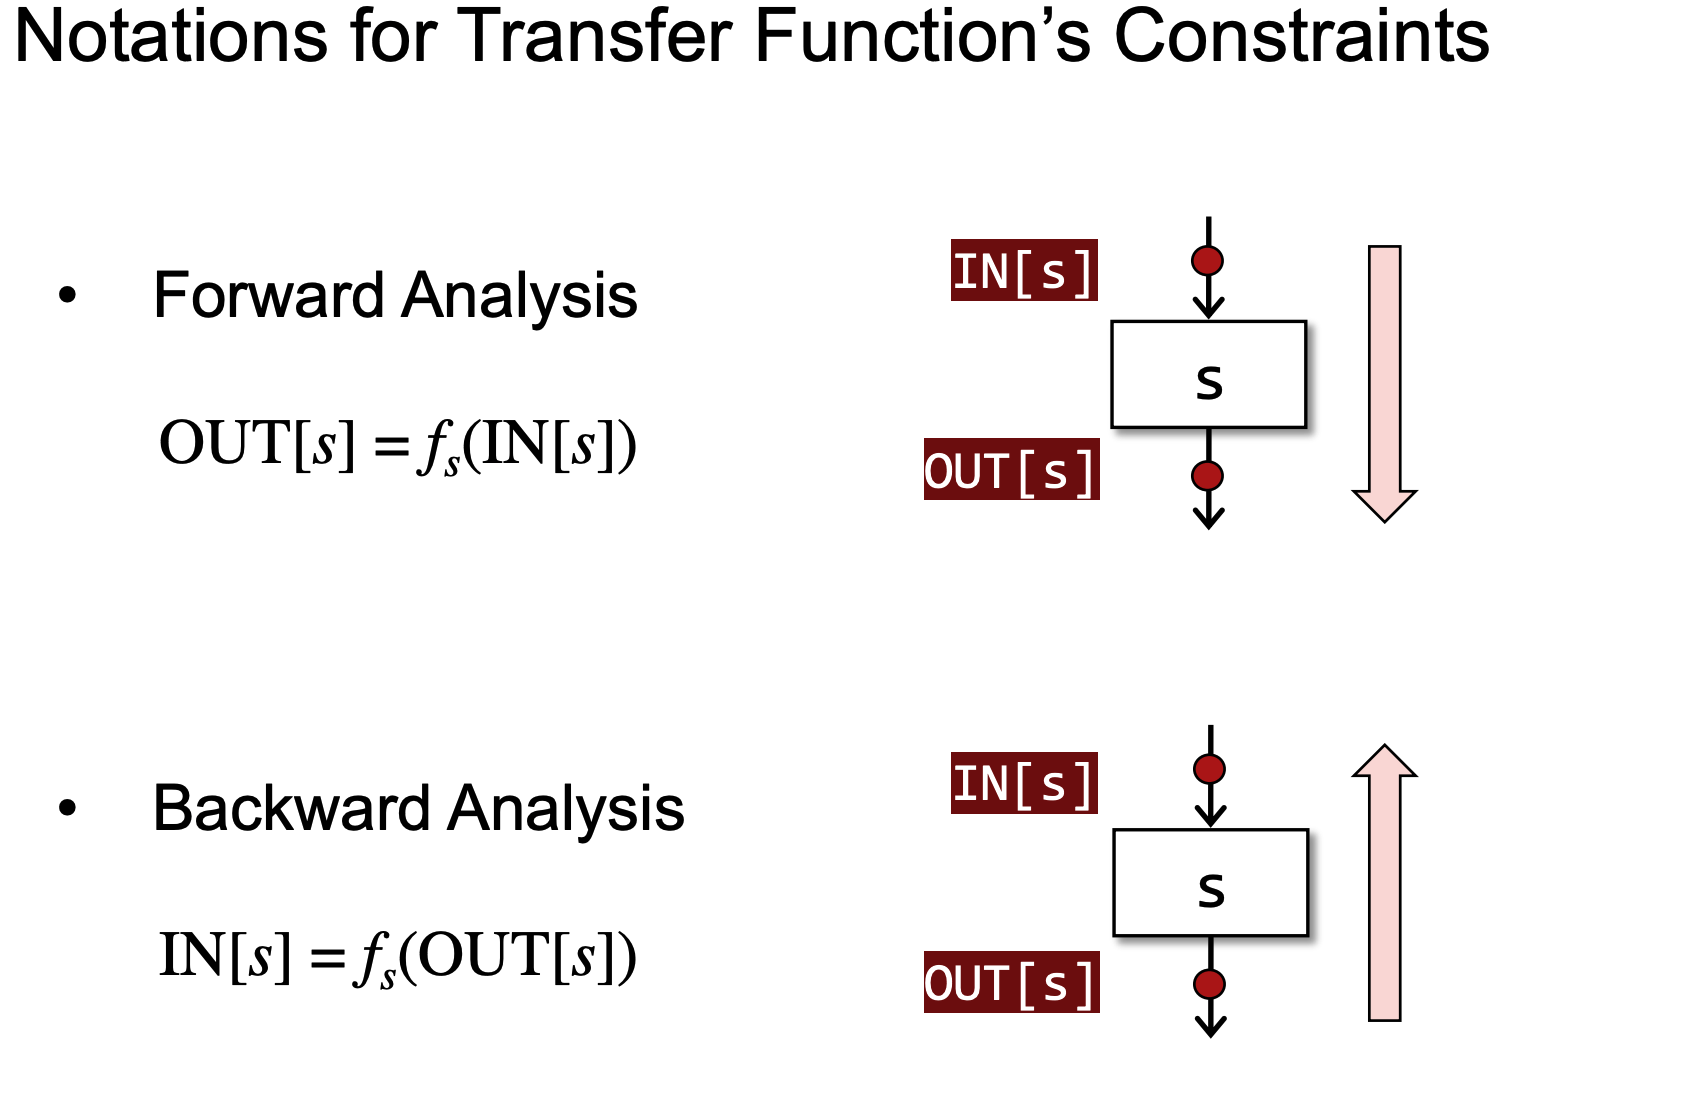
有两种入手分析的方式,自上而下分析(Forward)和自下而上(Backward)分析,它们的方向是相反的,自然 apply 的 function 的逻辑也是反向的。
一般来说,使用 forwards anlaysis 的场景关注的是在那之前发生了什么,而使用 backwards analaysis 的场景关注在那之后发生了什么。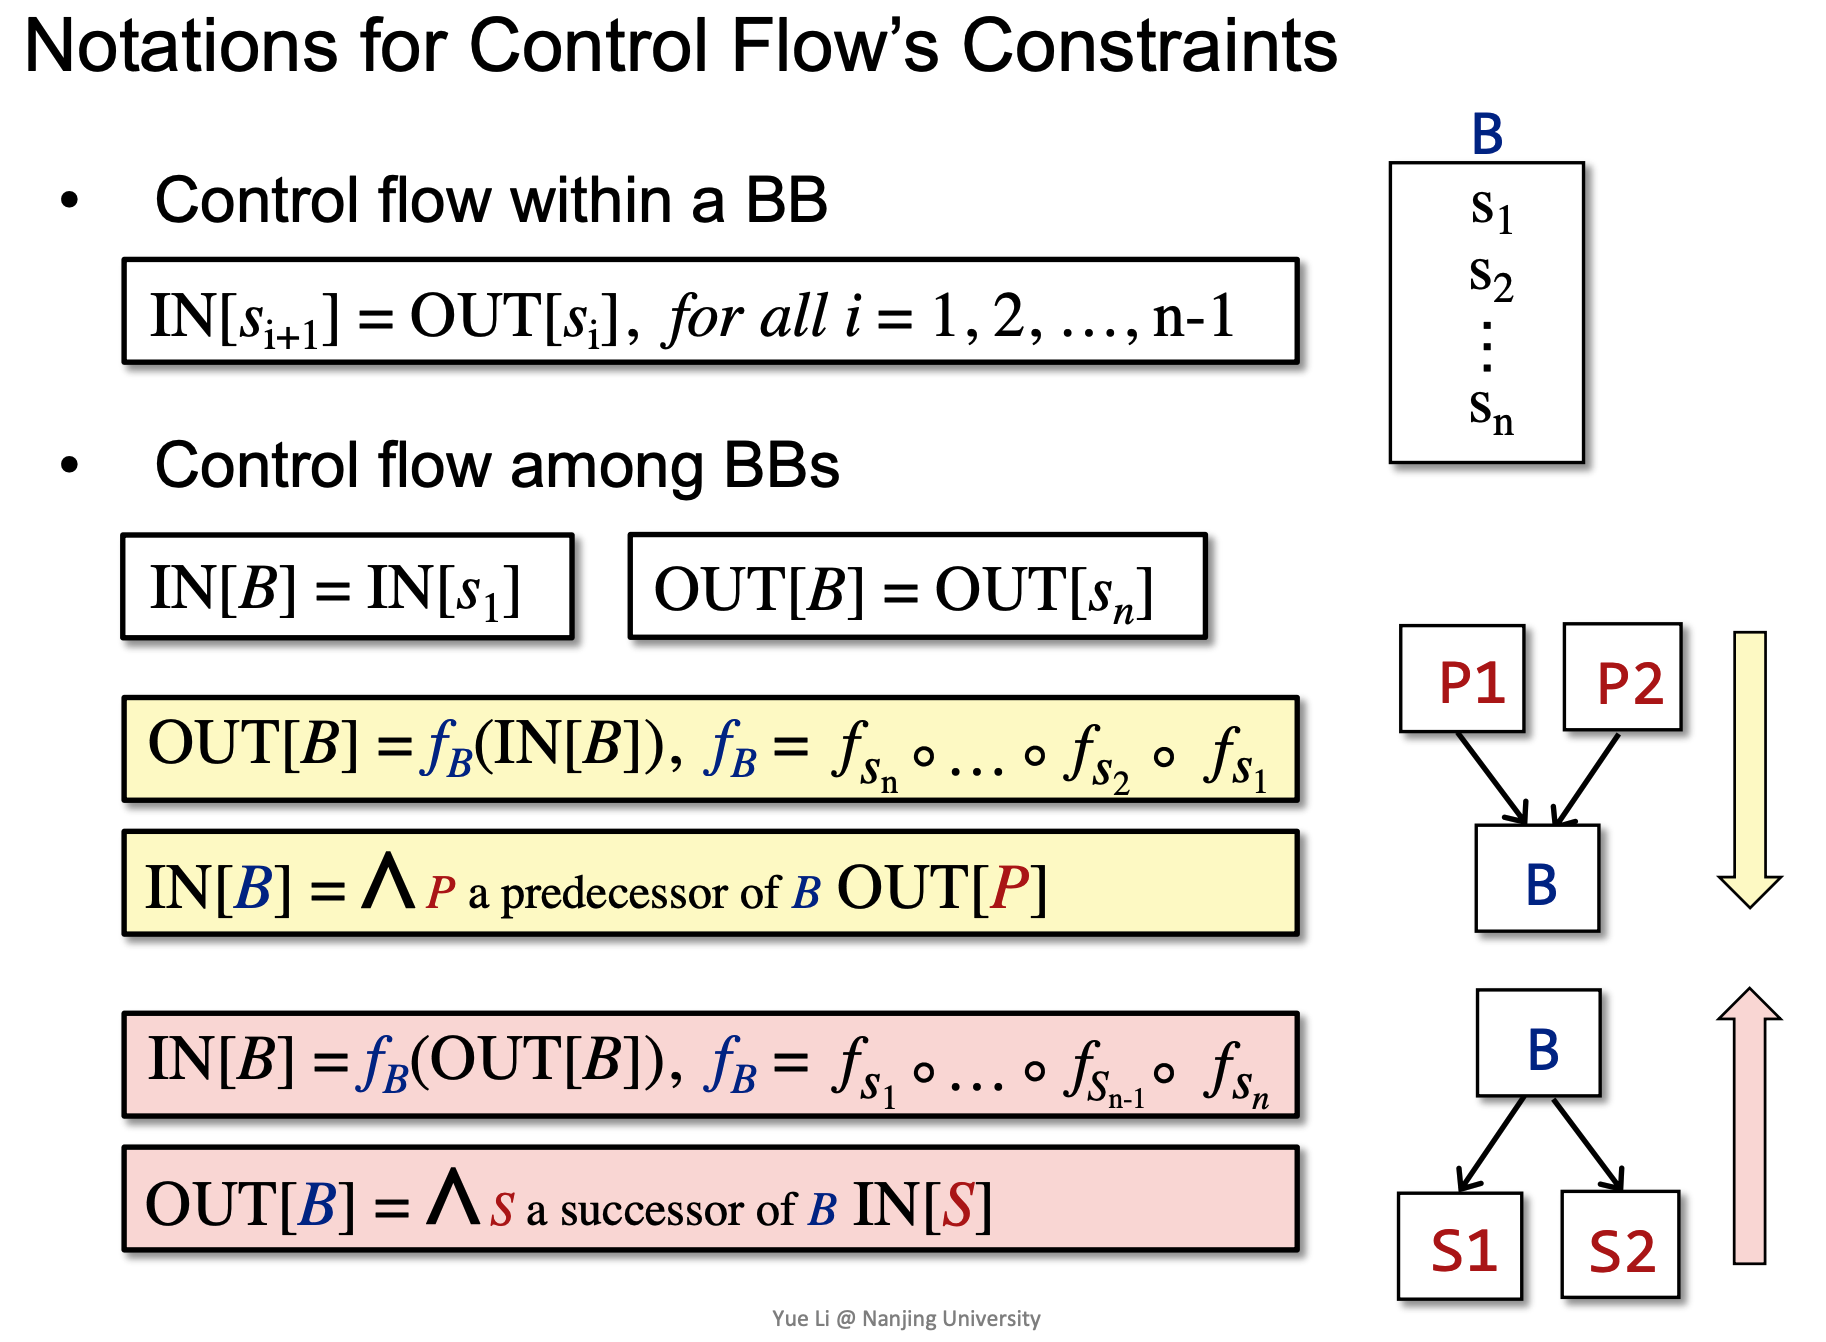
并且从逻辑上我们可以把整个 base block(B) 的状态转换表示为其中 statement(s) 的组合,其中 base block 的输入即第一条 statement 的输入,输出即最后一条 statement 的输出。
Reaching Definitions Analysis
因为 reaching definitions analysis 是为了分析出可能能 reach 到的 definition,从而取反得到不可能 reach 的 definition,进而将他们优化掉。
我们肯定是不能接受可能 reach 到的 definition 被优化掉的,所以对于可能 reach 到的 definition ,宁多报,不漏报,所以我们使用 may analysis。
Transfer Function
这里需要先提到 Gen 集和 Kill 集的概念。
Gen 集:在分析到一行 statement 时,其使用到的 variable 会被加入到 Gen 集。
Kill 集:在分析到一行 statement 时,其定义的variable 会被加入到 Kill 集。
对于 Reaching Definitions Analysis 这个场景,每个节点保存的状态其实就是在这个节点有哪些变量被使用了,并且如果存在重复的变量定义,需要将其从结果中去除,写成 Transfer Function 就是:
$$
OUT[B]=gen_BU(IN[B] - kill_B)
$$
Algorithm
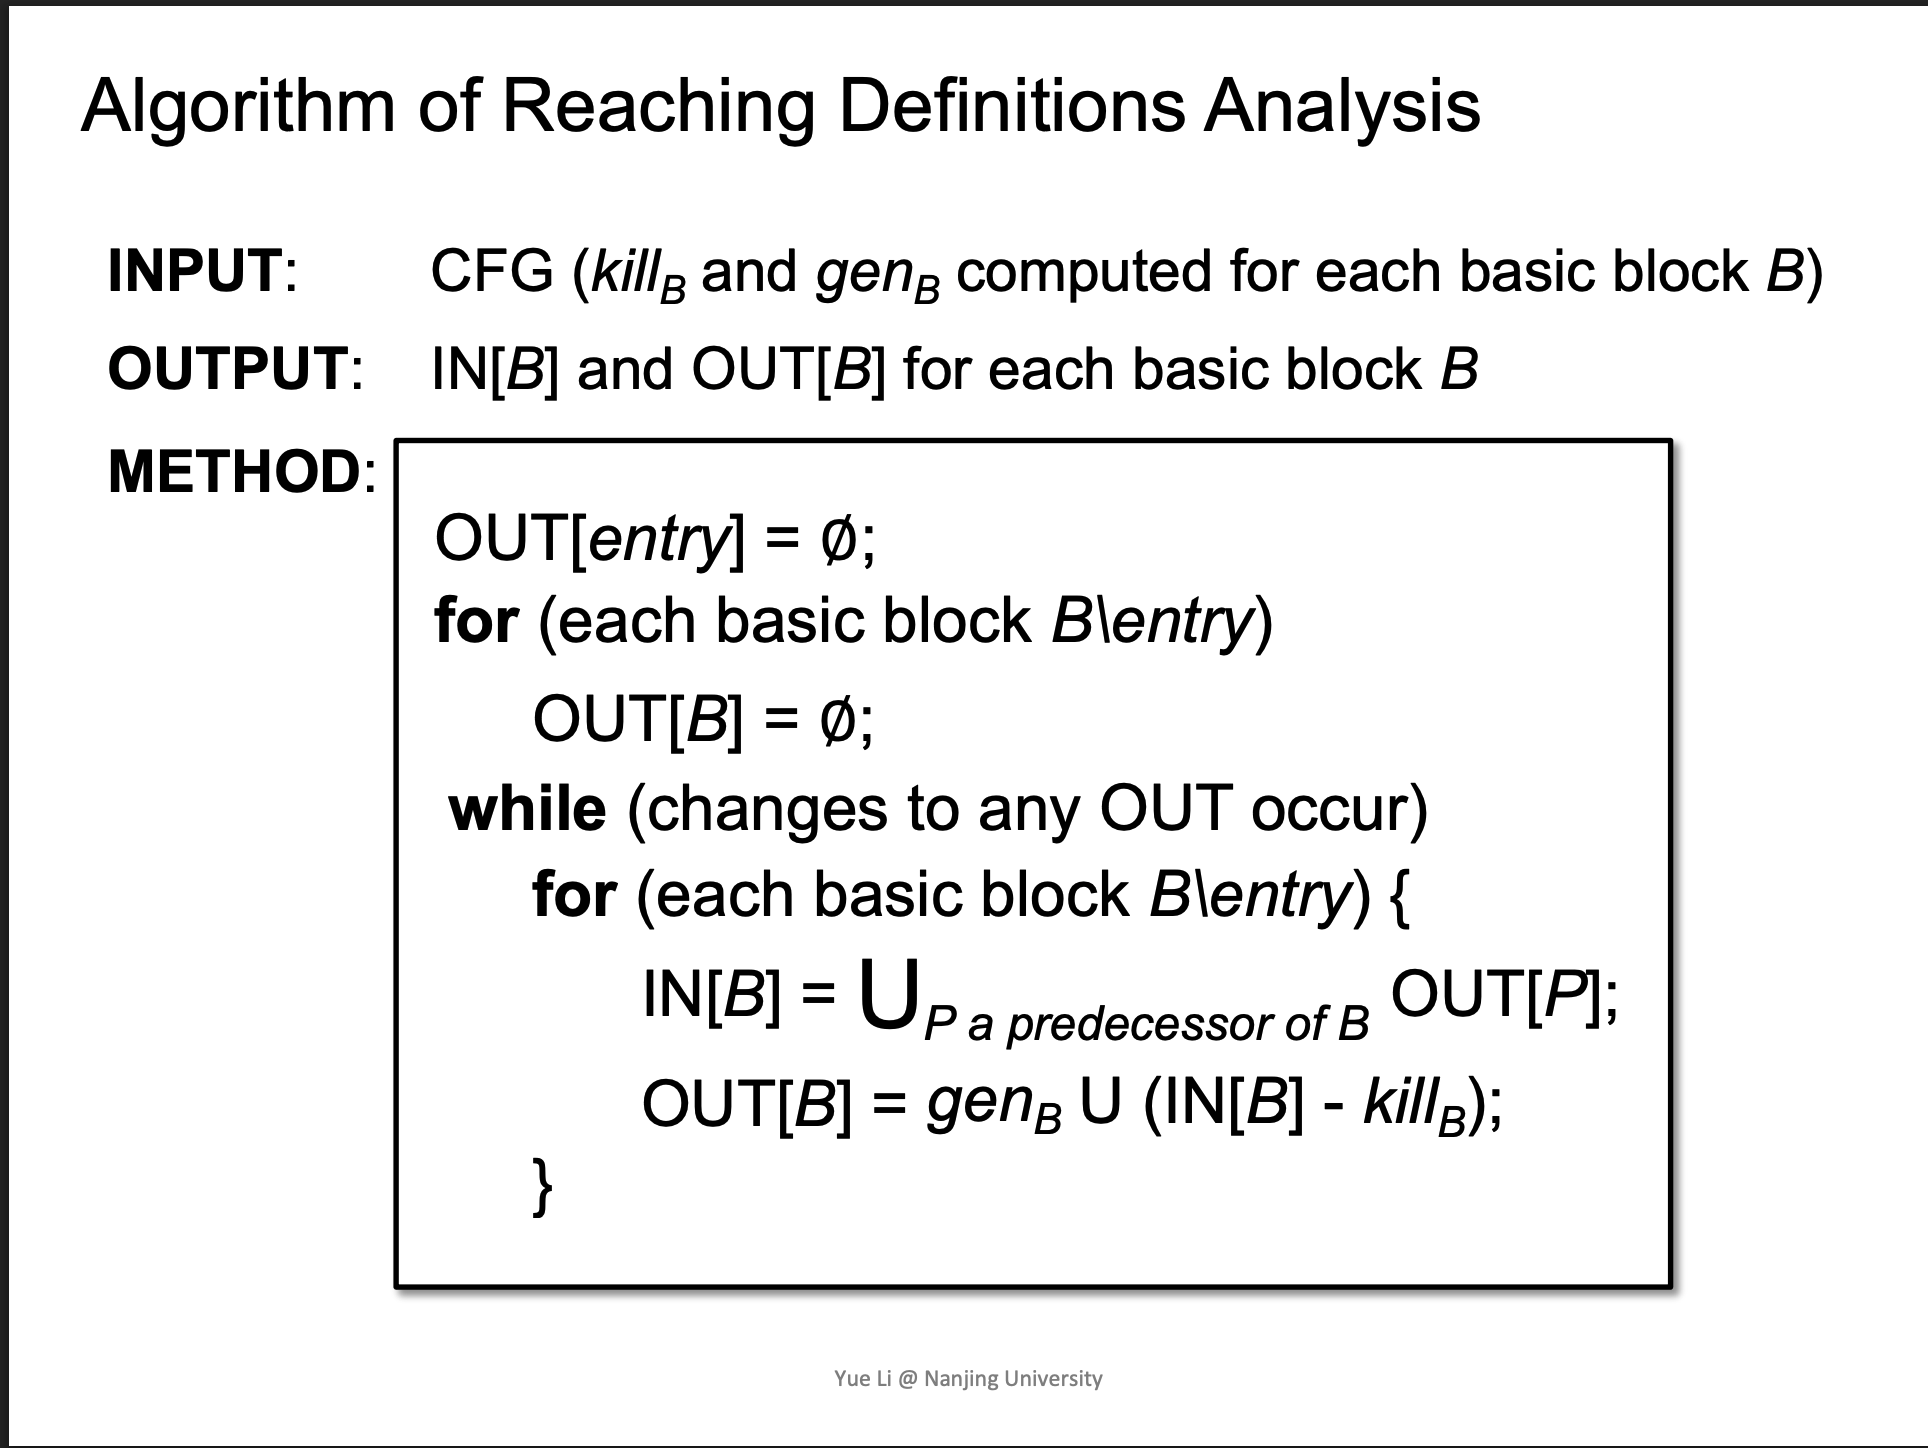
口述一下算法其实就是,先初始化所有状态为空状态,然后不断遍历更新每个节点的 IN 状态和 OUT 状态,直到后来所有节点的 OUT 状态都不再发生改变。
由于 Reaching Definitions Analysis 是 May analysis,所以 meet operator 取并集。
Reaching definitions analysis 关注在 exit 之前 variable 有没有 reach,所以我们使用 forwards analysis。
Example
在实操中我们可以用 bit vector 来编码每个节点对应所有 variable 是否被引用的状态,对应的取并集也很方便。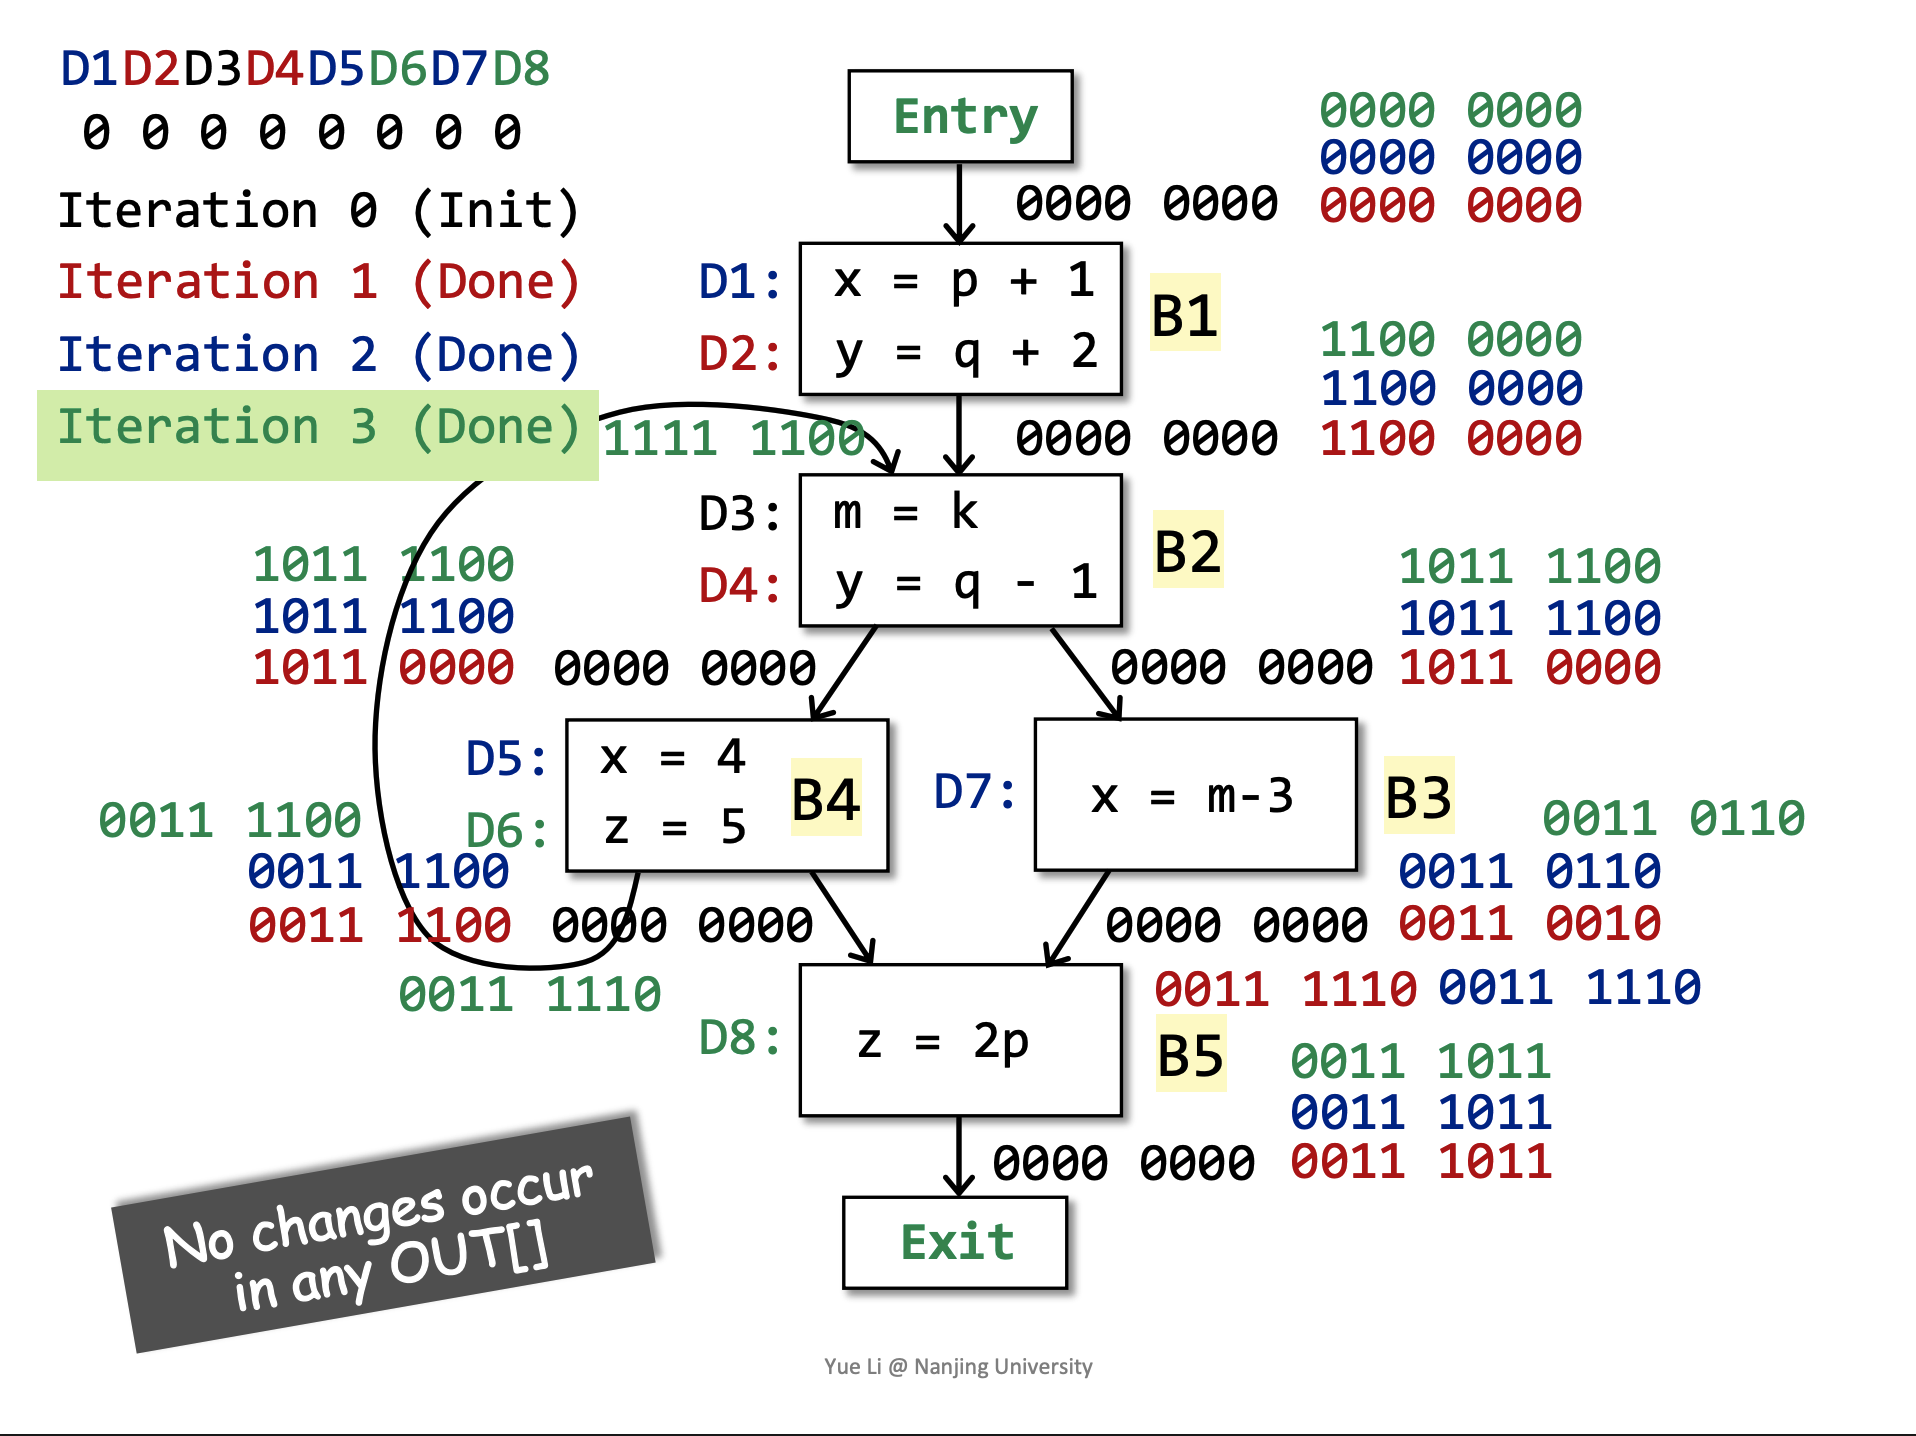
Live Variables Analysis
如果变量 v 在点 p 的值在路径中未来会被用到,且在这之前没有被重新赋值,那么 v 在 p 点是活跃的。
v 在被使用之前不能被 redefine,因为 redefine 之后的 use 使用的就不是原本的变量了
Live variables analysis 适合使用 backwards anlaysis 进行分析,因为它关注的是在 p 点之后变量 v 有没有被使用。
由于只要后面有任何一种可能的分支用到这个变量,我们就认为这个变量是 live 的,所以它是 may analysis。
Transfer Function
自底向上分析,Live Variable 集合的定义其实就是下面 use 过的,并且遇到 definition 就将其去掉
$$
IN[B] = use_B U (OUT[B] - def_B)
$$
Algorithm
其实跟上面 Reaching Definition Analysis 基本上差不多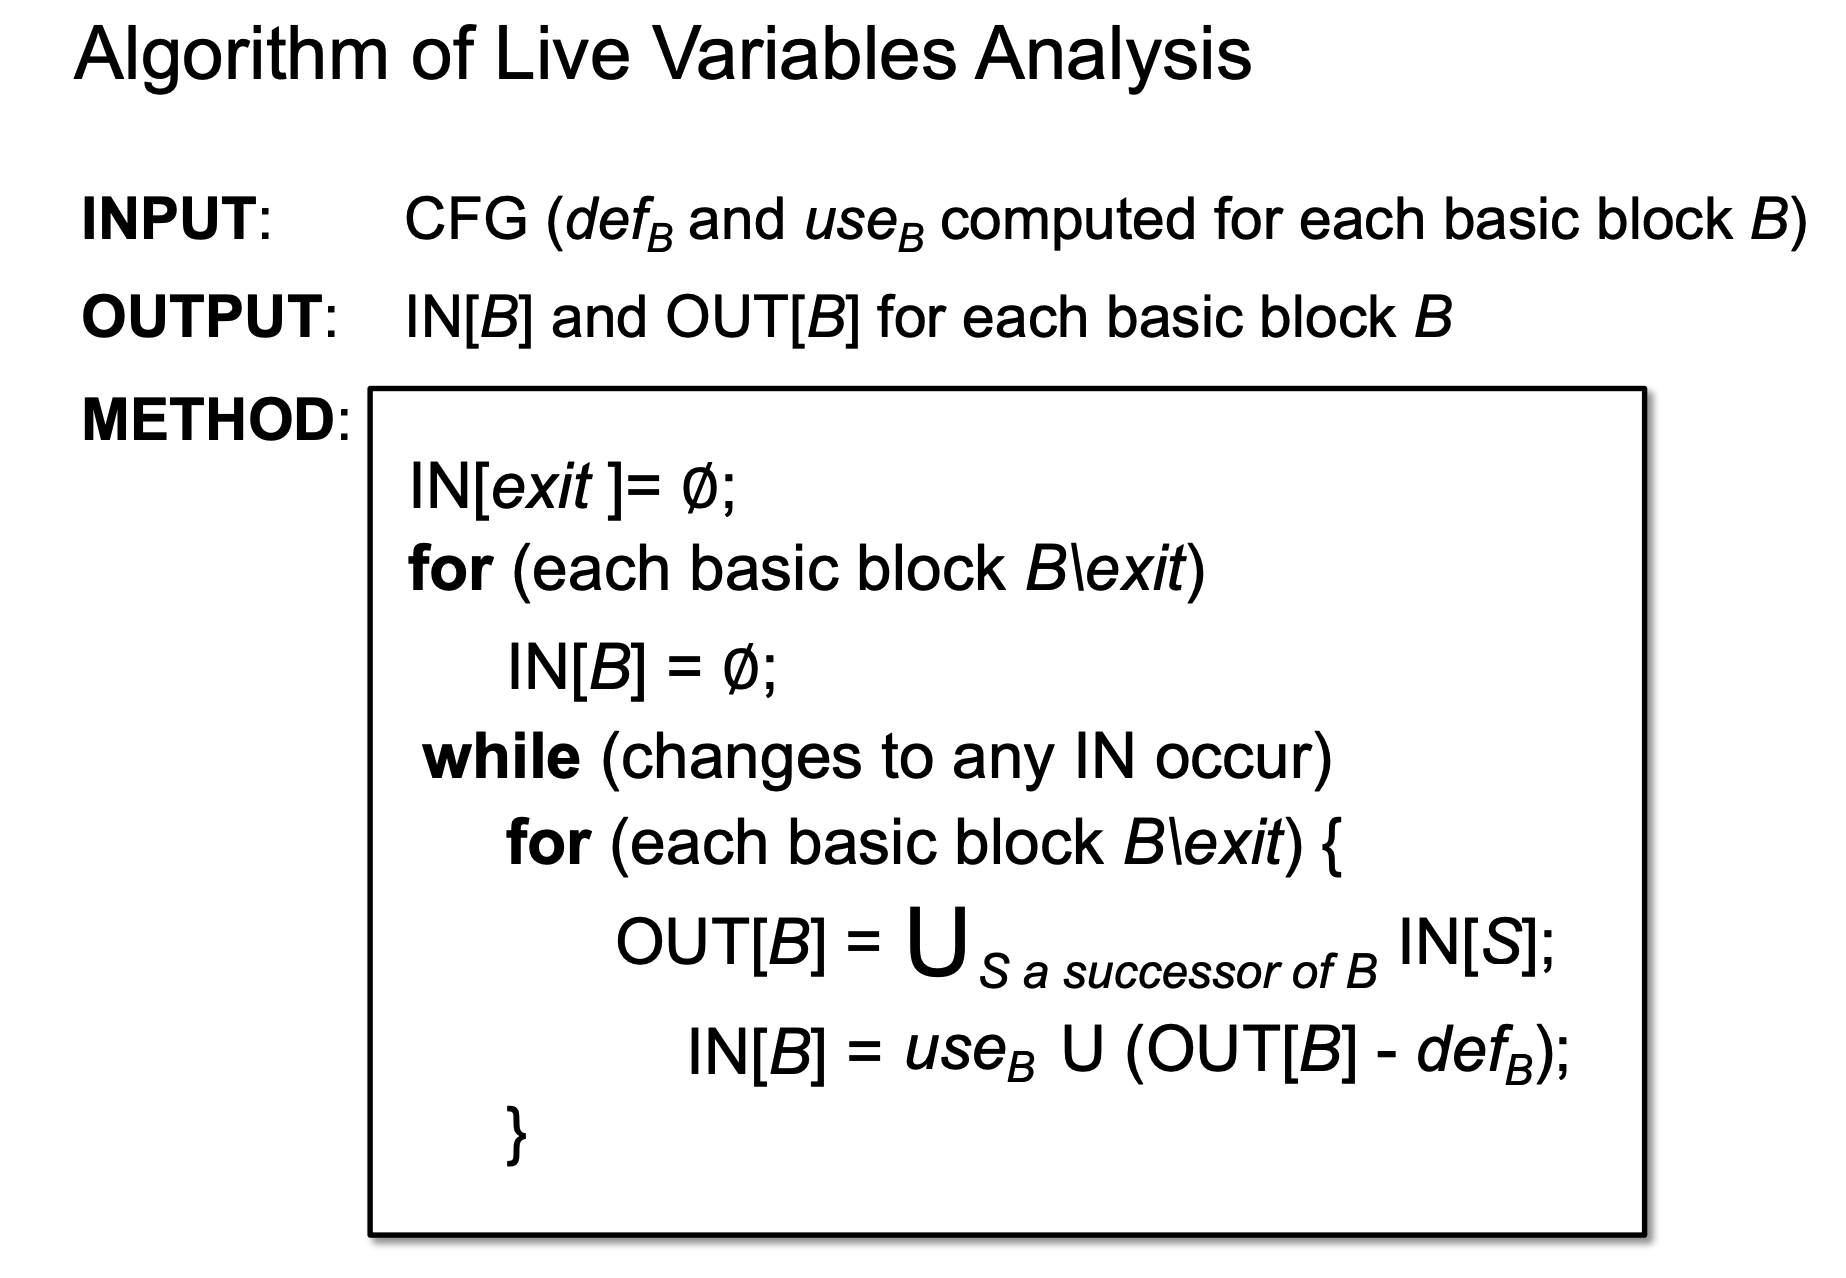
Example
不同于上面 Reaching Definition Analysis,bit vector 编码的是变量,并且分析是从末尾 exit 开始的。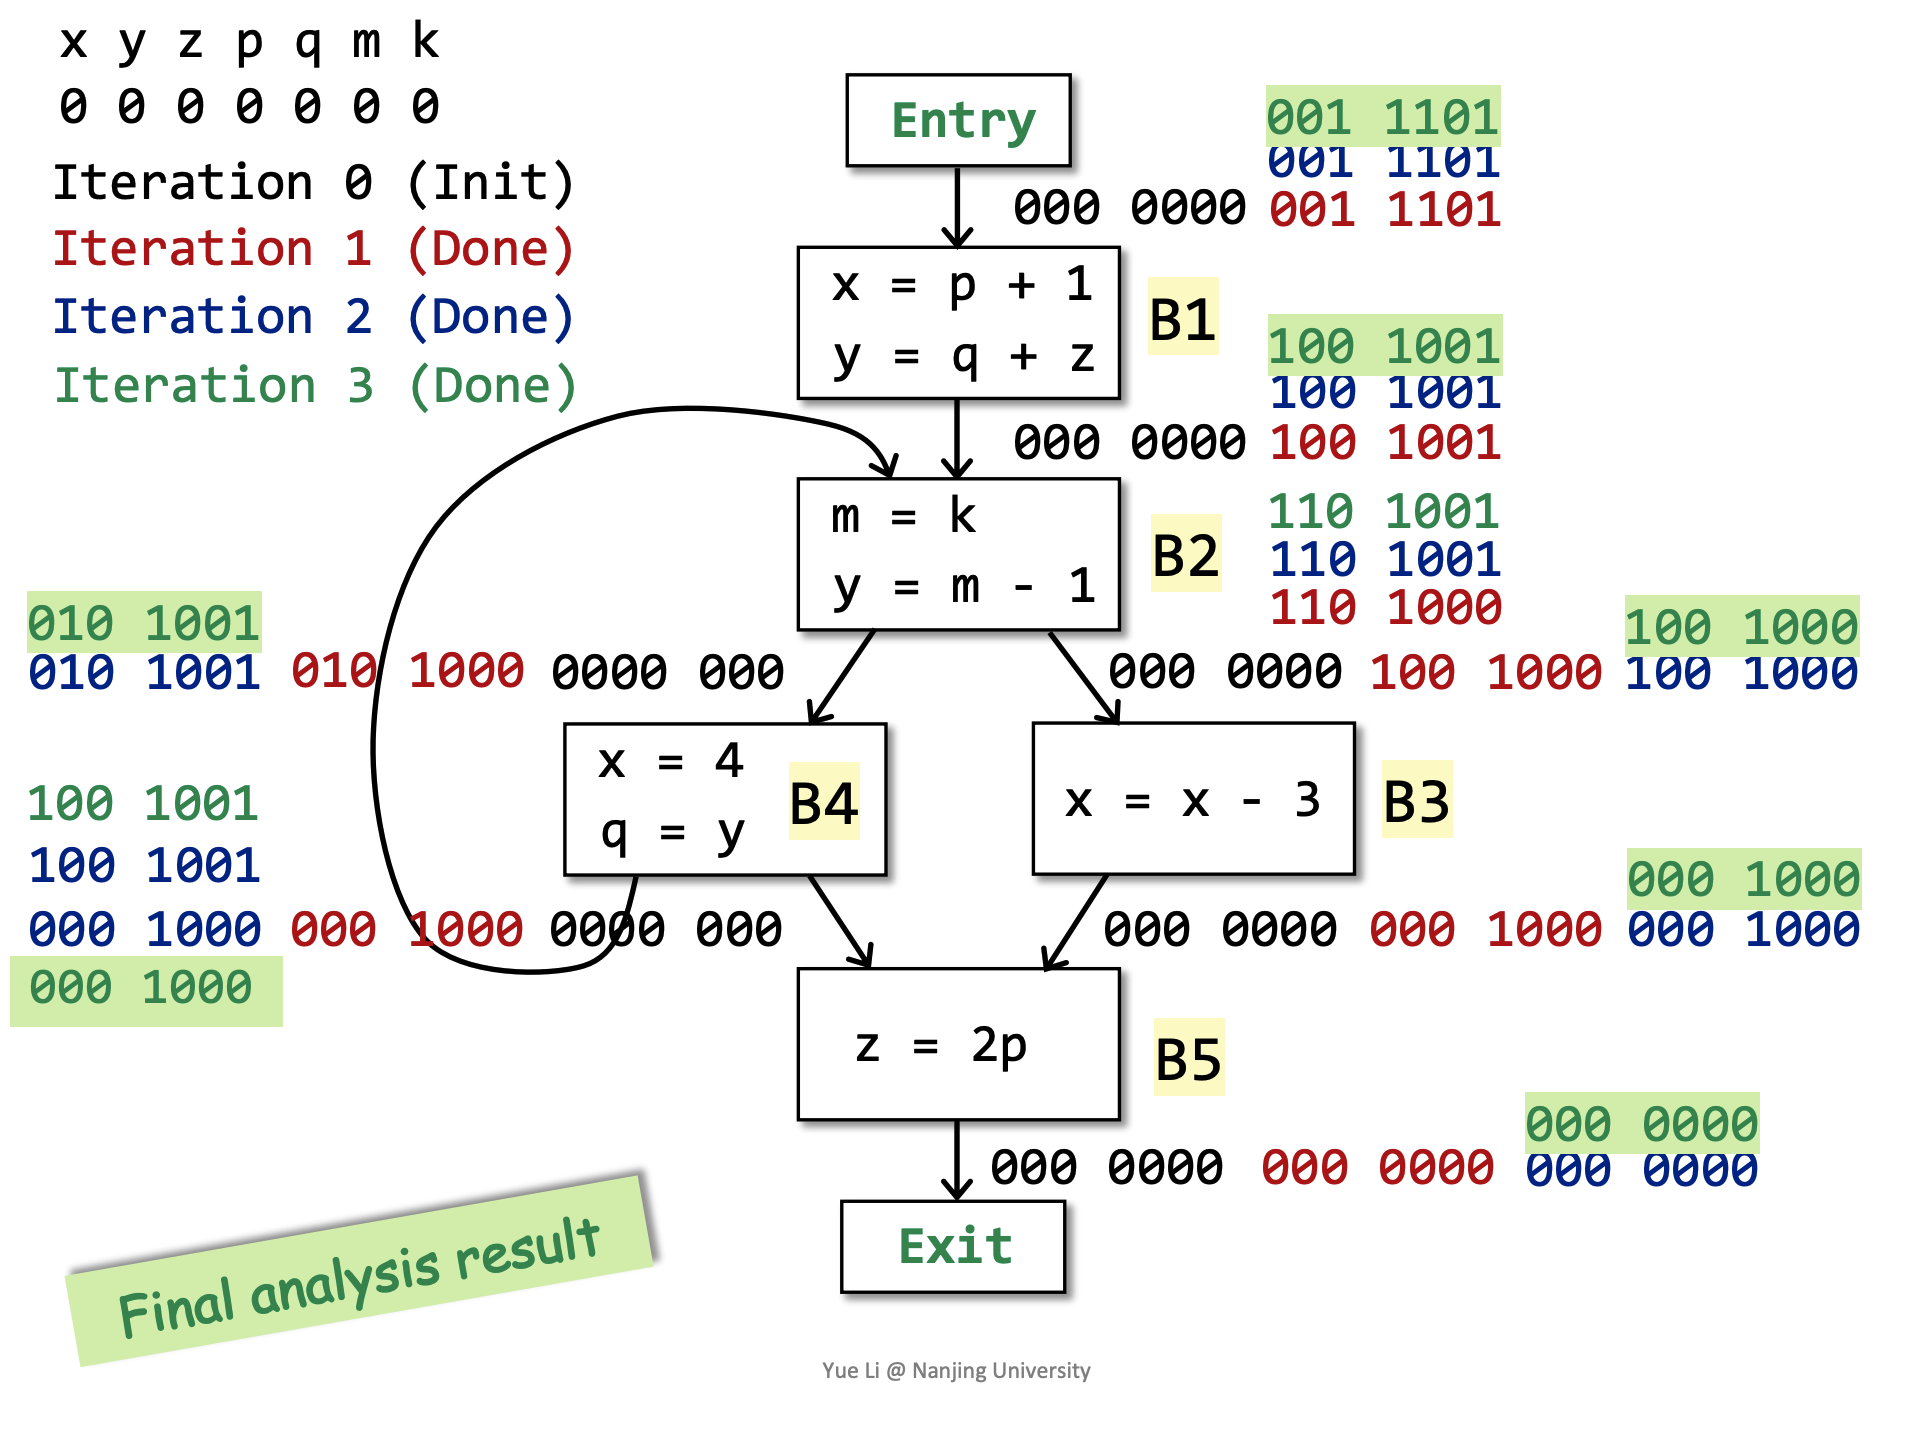
Available Expressions Analysis
An expression x op y is available at program point p if
(1) all paths from the entry to p must pass through the evaluation of x op y, and
(2) after the last evaluation of x op y, there is no redefinition of x or y
Avaliable expressions analysis 的主要应用是_全局公共子表达式消除(Common Subexpression Elimination)。_如果编译器想把点 p 处的 a = x + y 替换成 a = temp ,它必须确定在所有情况下 x + y都已经算过了,并且值没有变。
1 | static void exampleFunc(ExampleEnum enum, int x, int y) { |
为什么必须确定所有情况下 x + y 都已经算过了?假如有些 case 没有算过这个 x + y 又会有什么问题吗,这就要考虑到除零问题了,算术操作实际上也是有 side effect 的:
1 | static void func(int a, int b) { |
确保值没有变就更好理解了,如果 x 和 y 的值变了,使用之前保存的表达式值就会得到一个错误的结果,影响结果的正确性。
因为既要保证全面所有分支都算过 x + y ,又要保证表达式后面 x 和 y 的值没有变过,所以这是一个 must analysis。
考虑到 avaliable expressions analysis 关注点 p 前面的所有分支都算过 x + y,且表达式到点 p 这一段 x 和 y 的值没有变过,所以要关注的是点 p 之前的状态,所以使用 forward analysis。
Algorithm
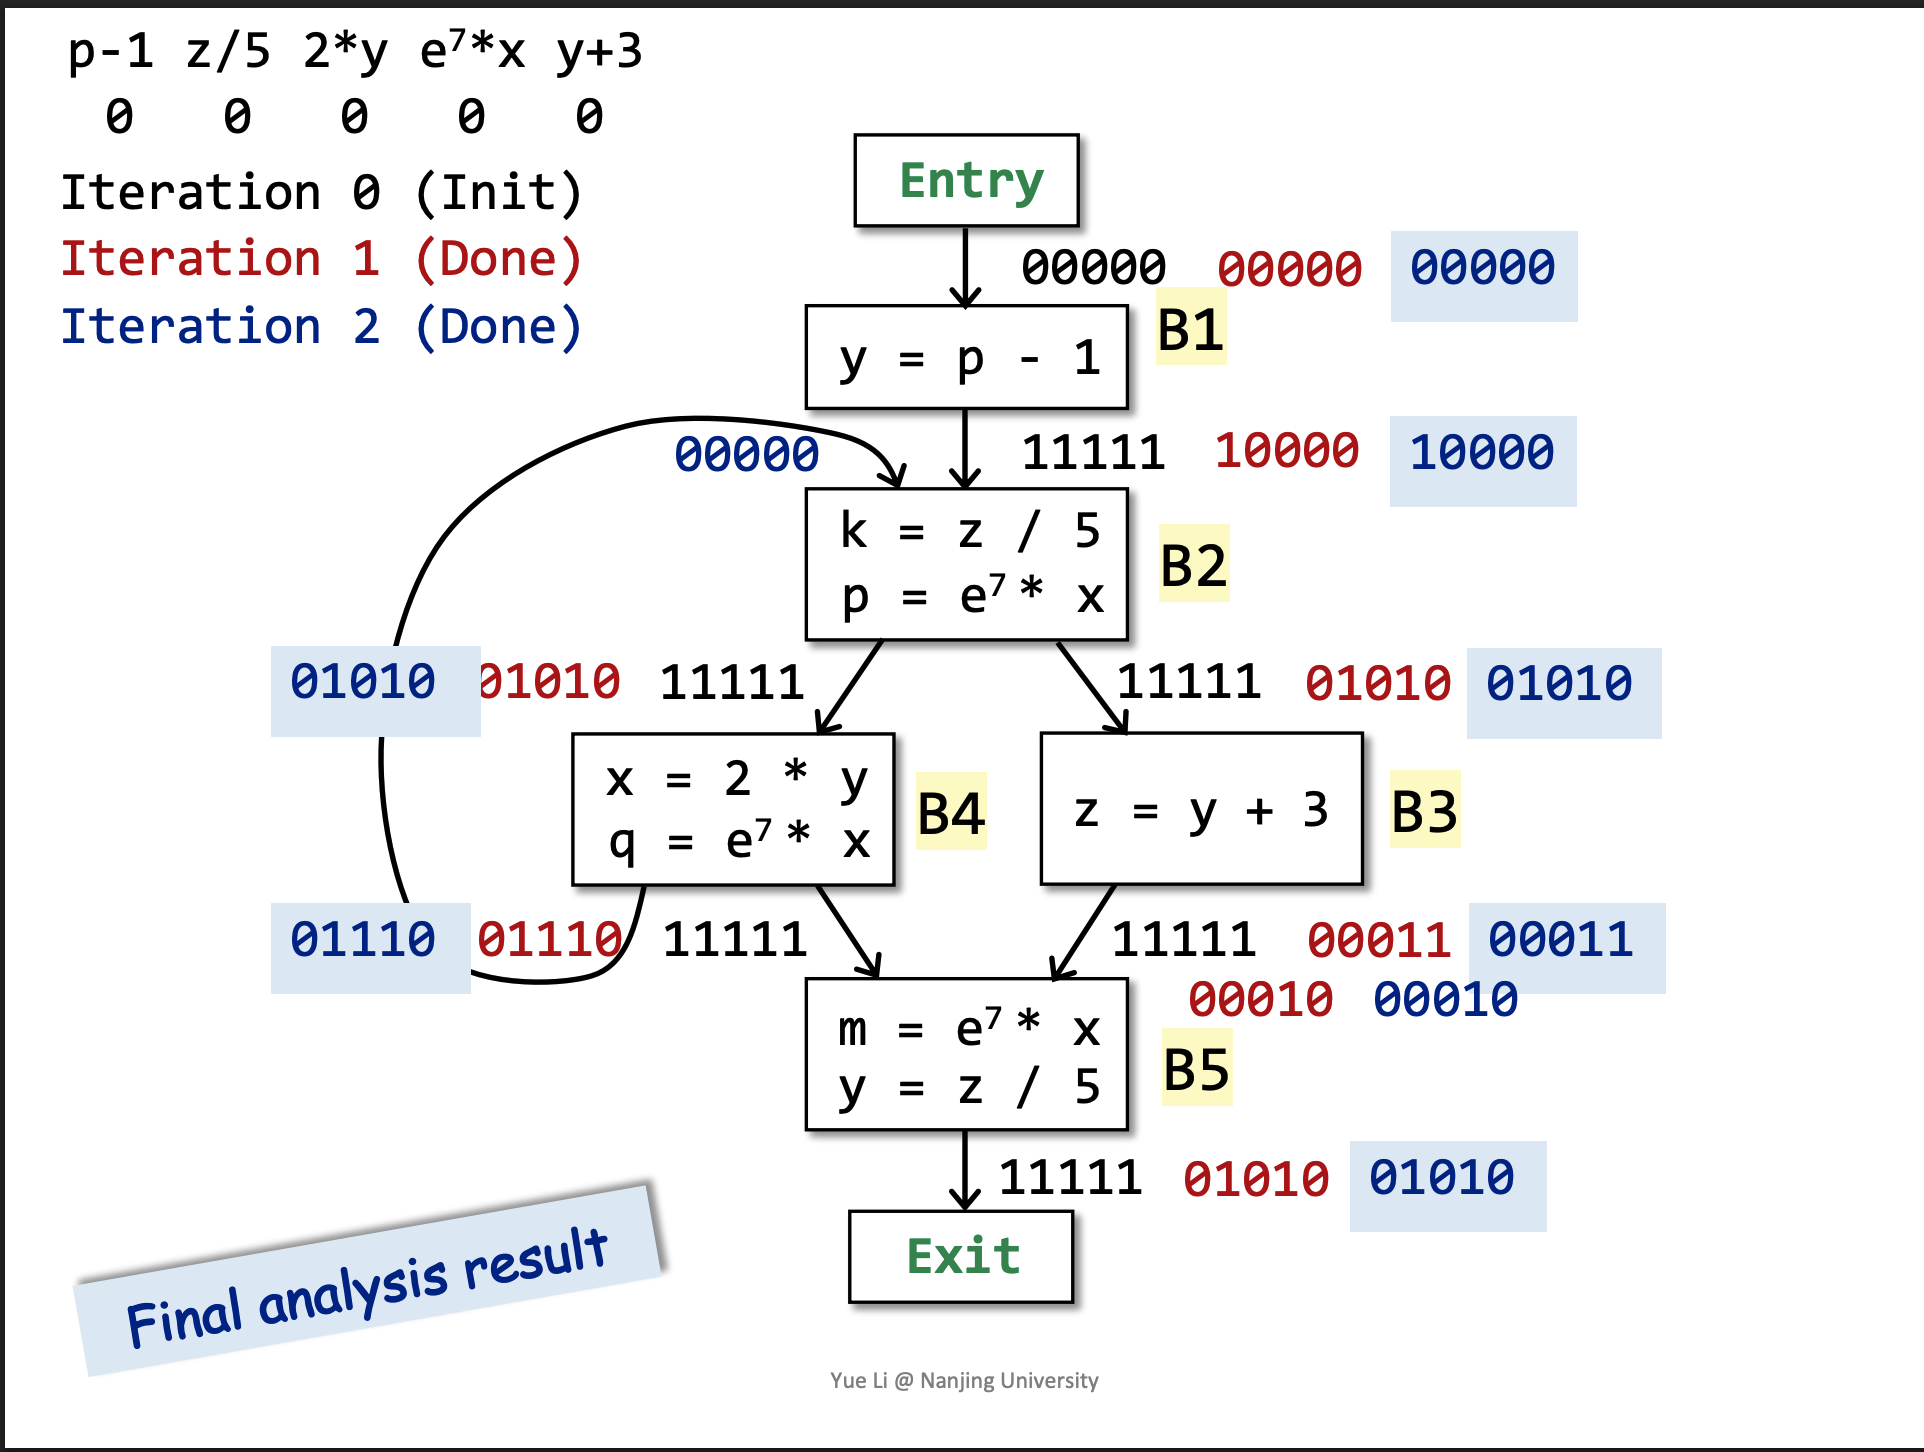
可以发现由于是 must anlaysis,所以其实是 IN[B] 的结果是前驱的几个 OUT 取交集。kill 和 gen 的含义也发生了变化:
kill:表达式x ``_op_`` y中的任意 variable (x, y) 被赋值,则 kill 掉这个表达式
gen:CFG 中包含制定表达式 x ``_op_`` y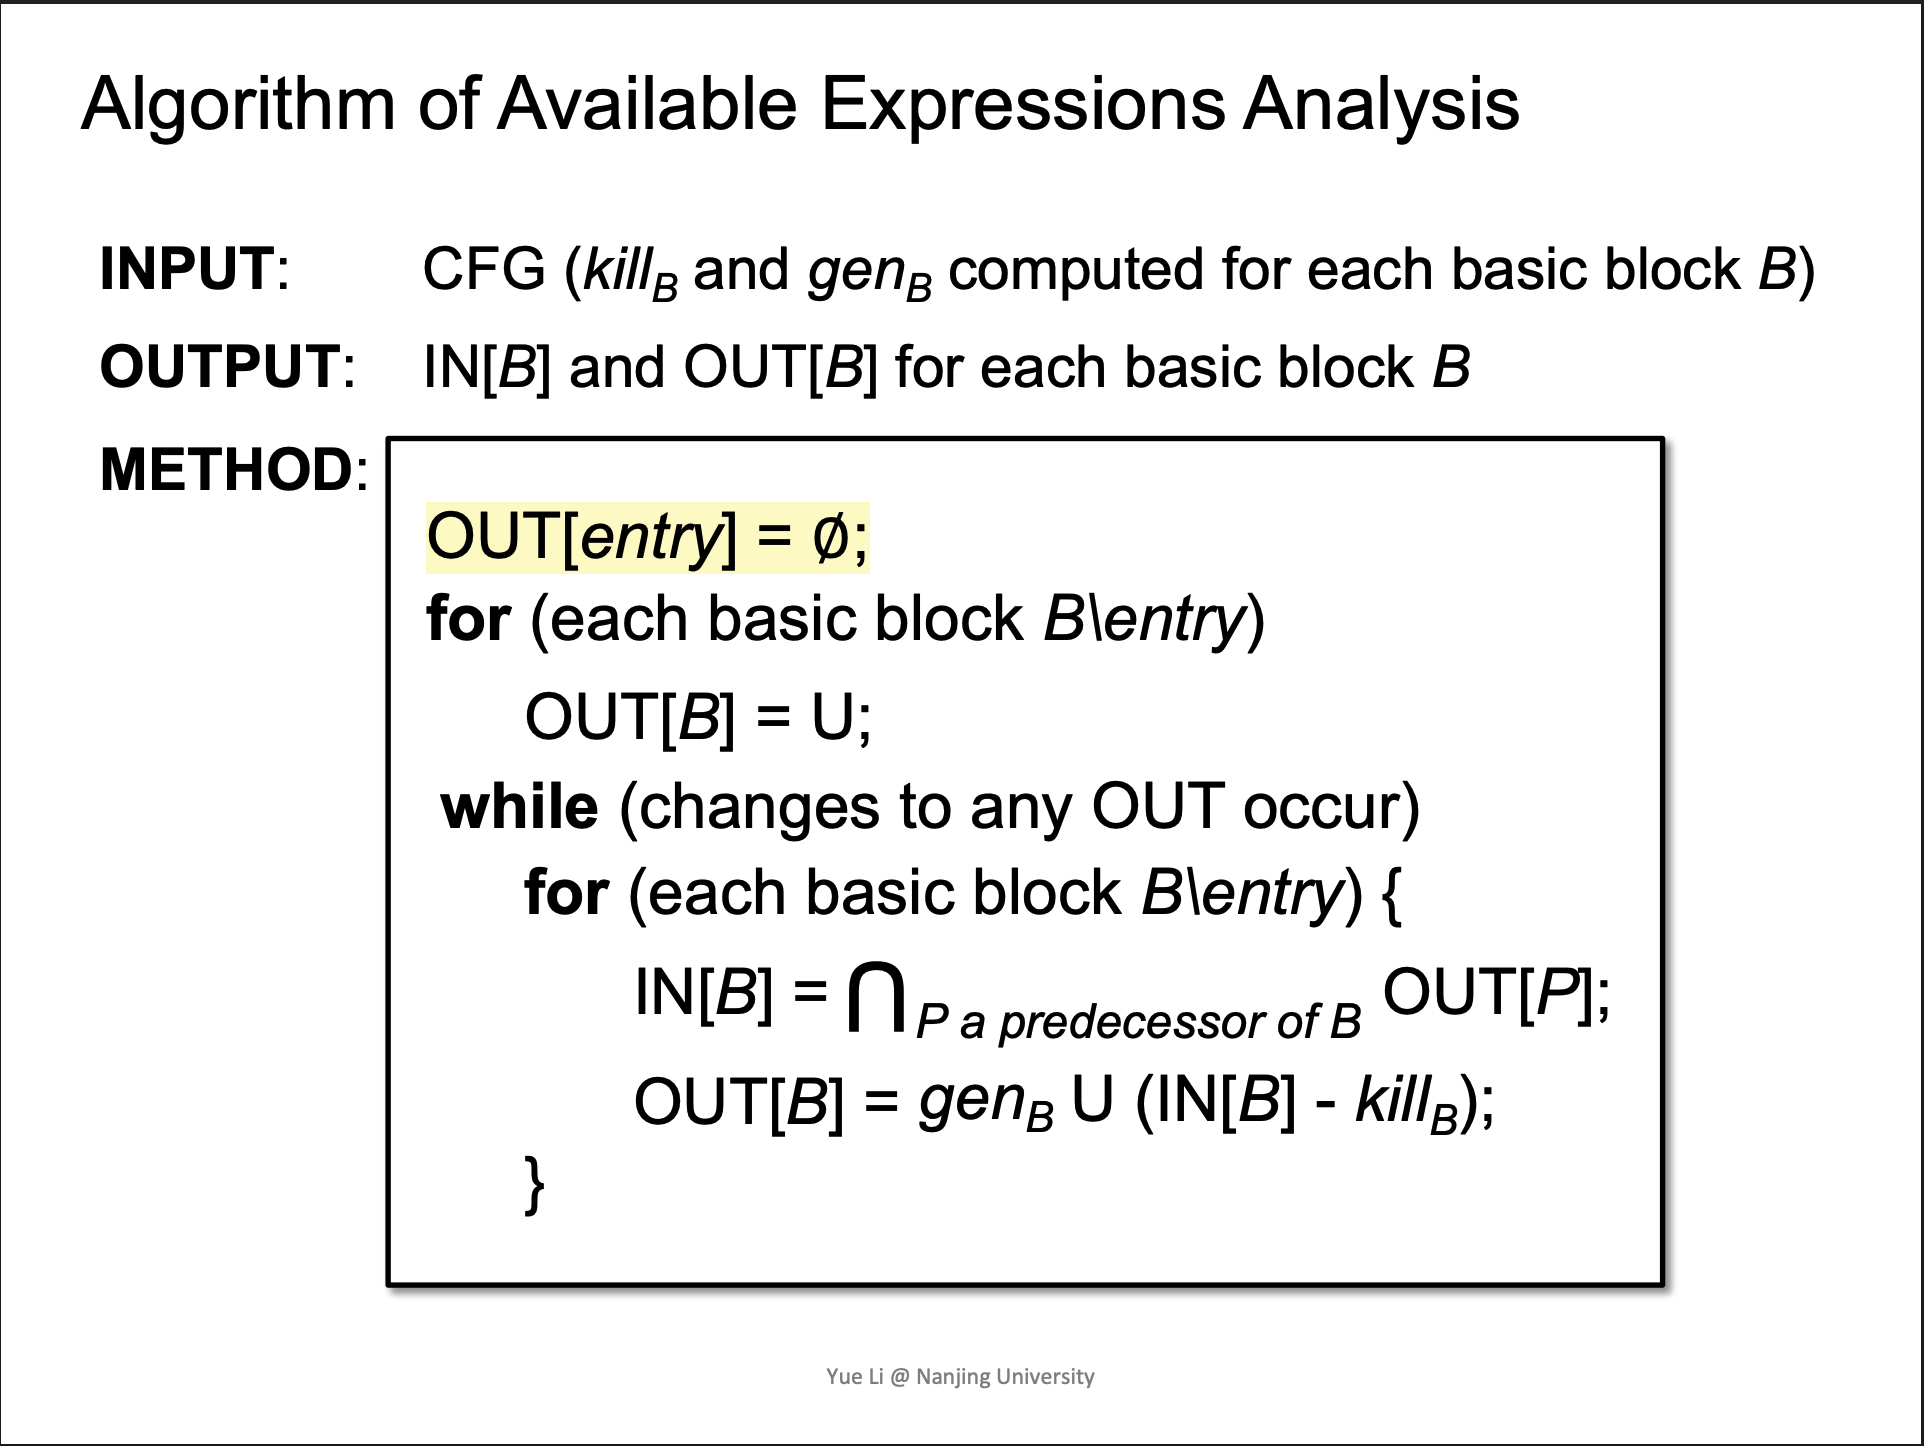
Example
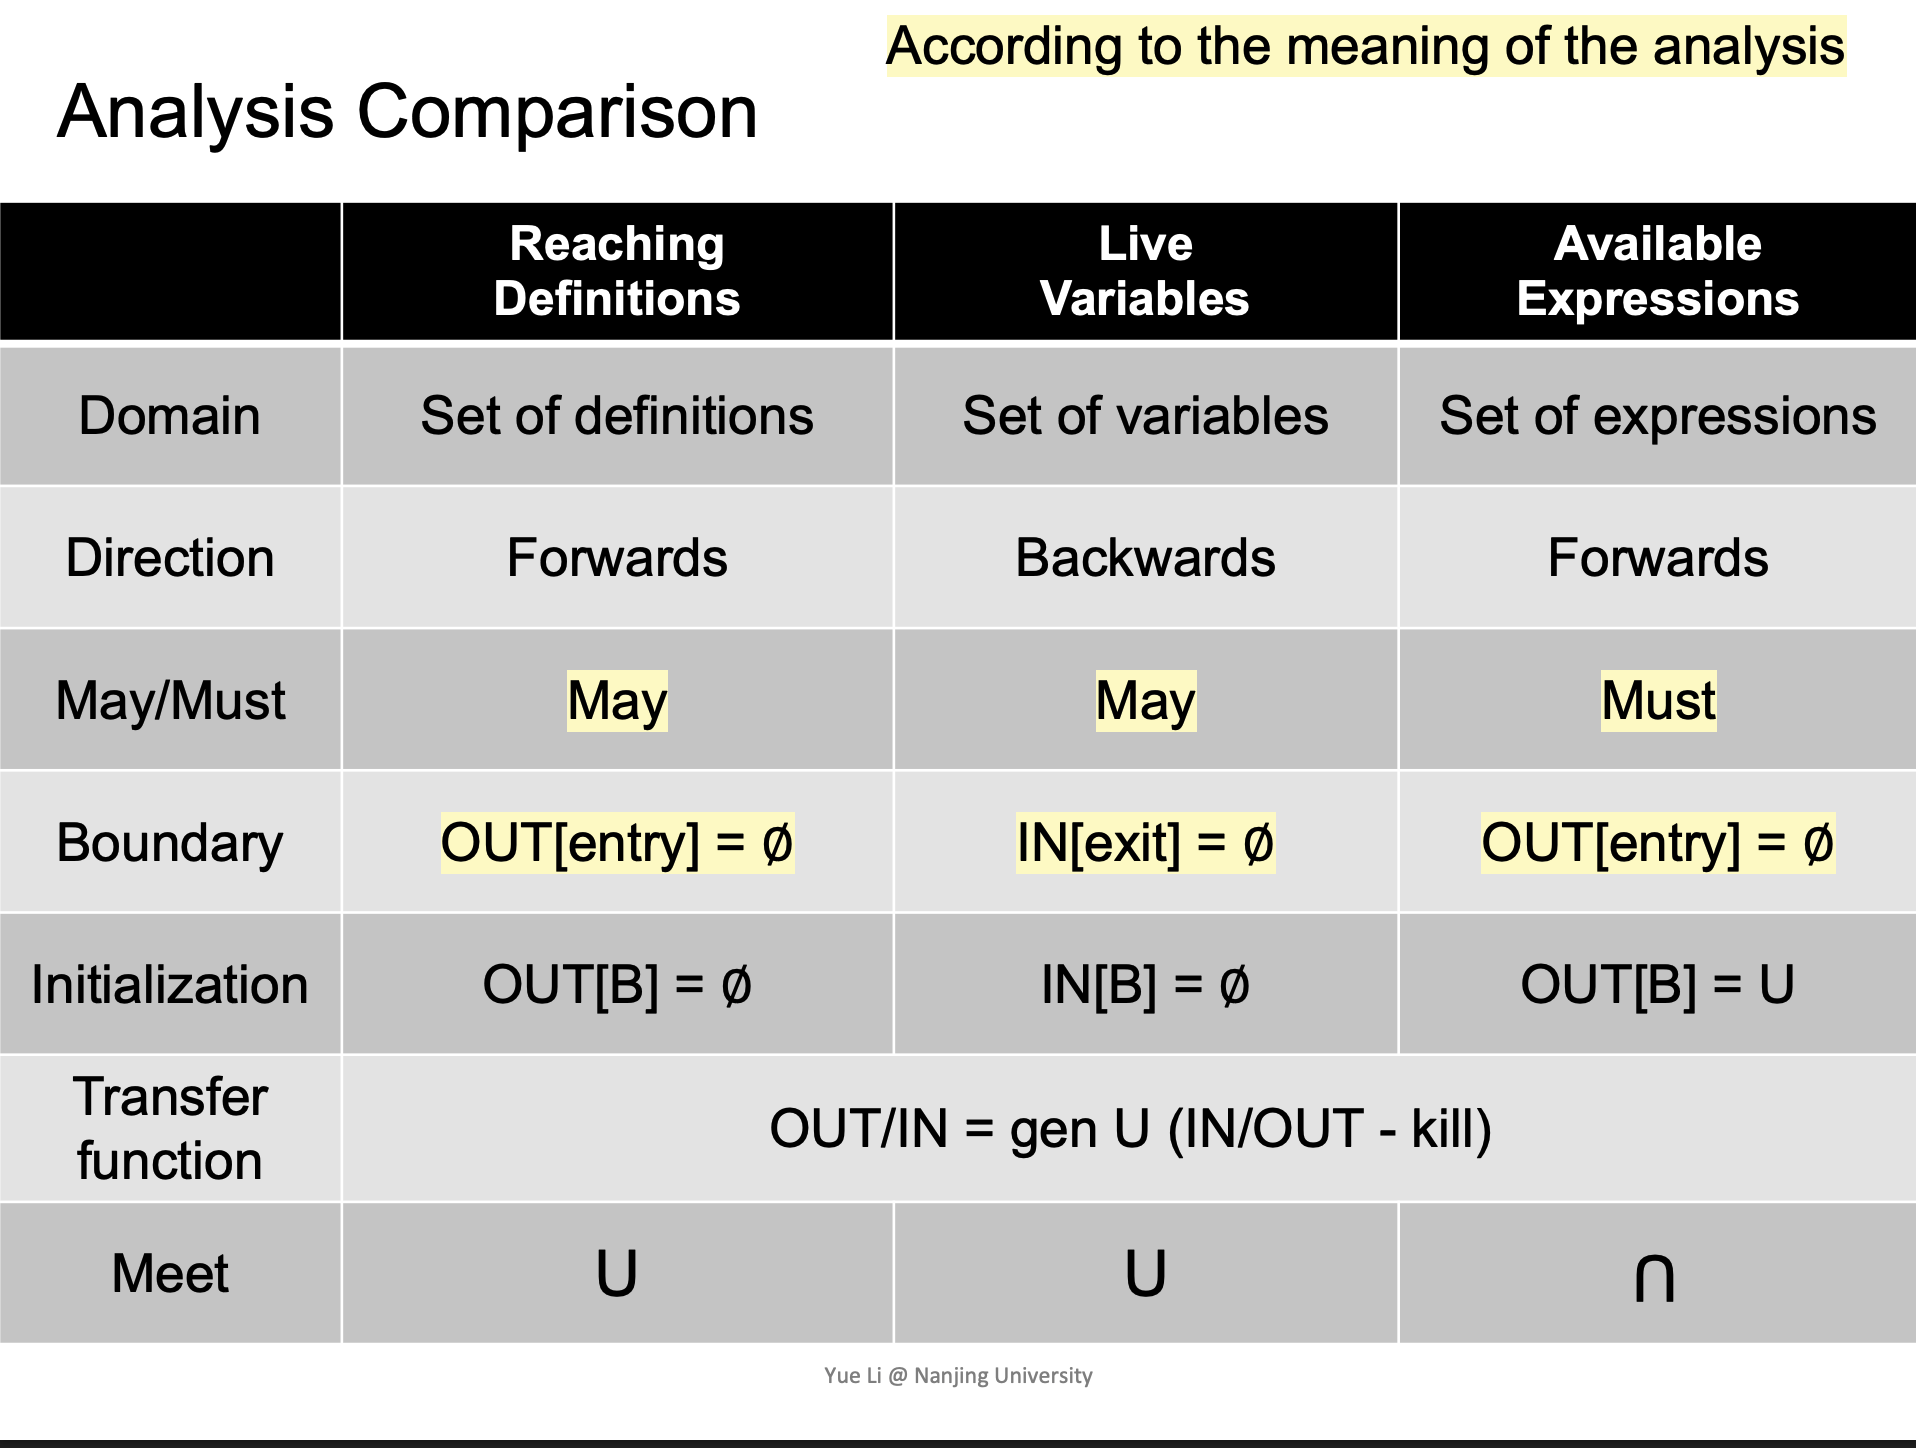
Summarize
Data Flow Analysis - Foundations
Iterative Algorithm
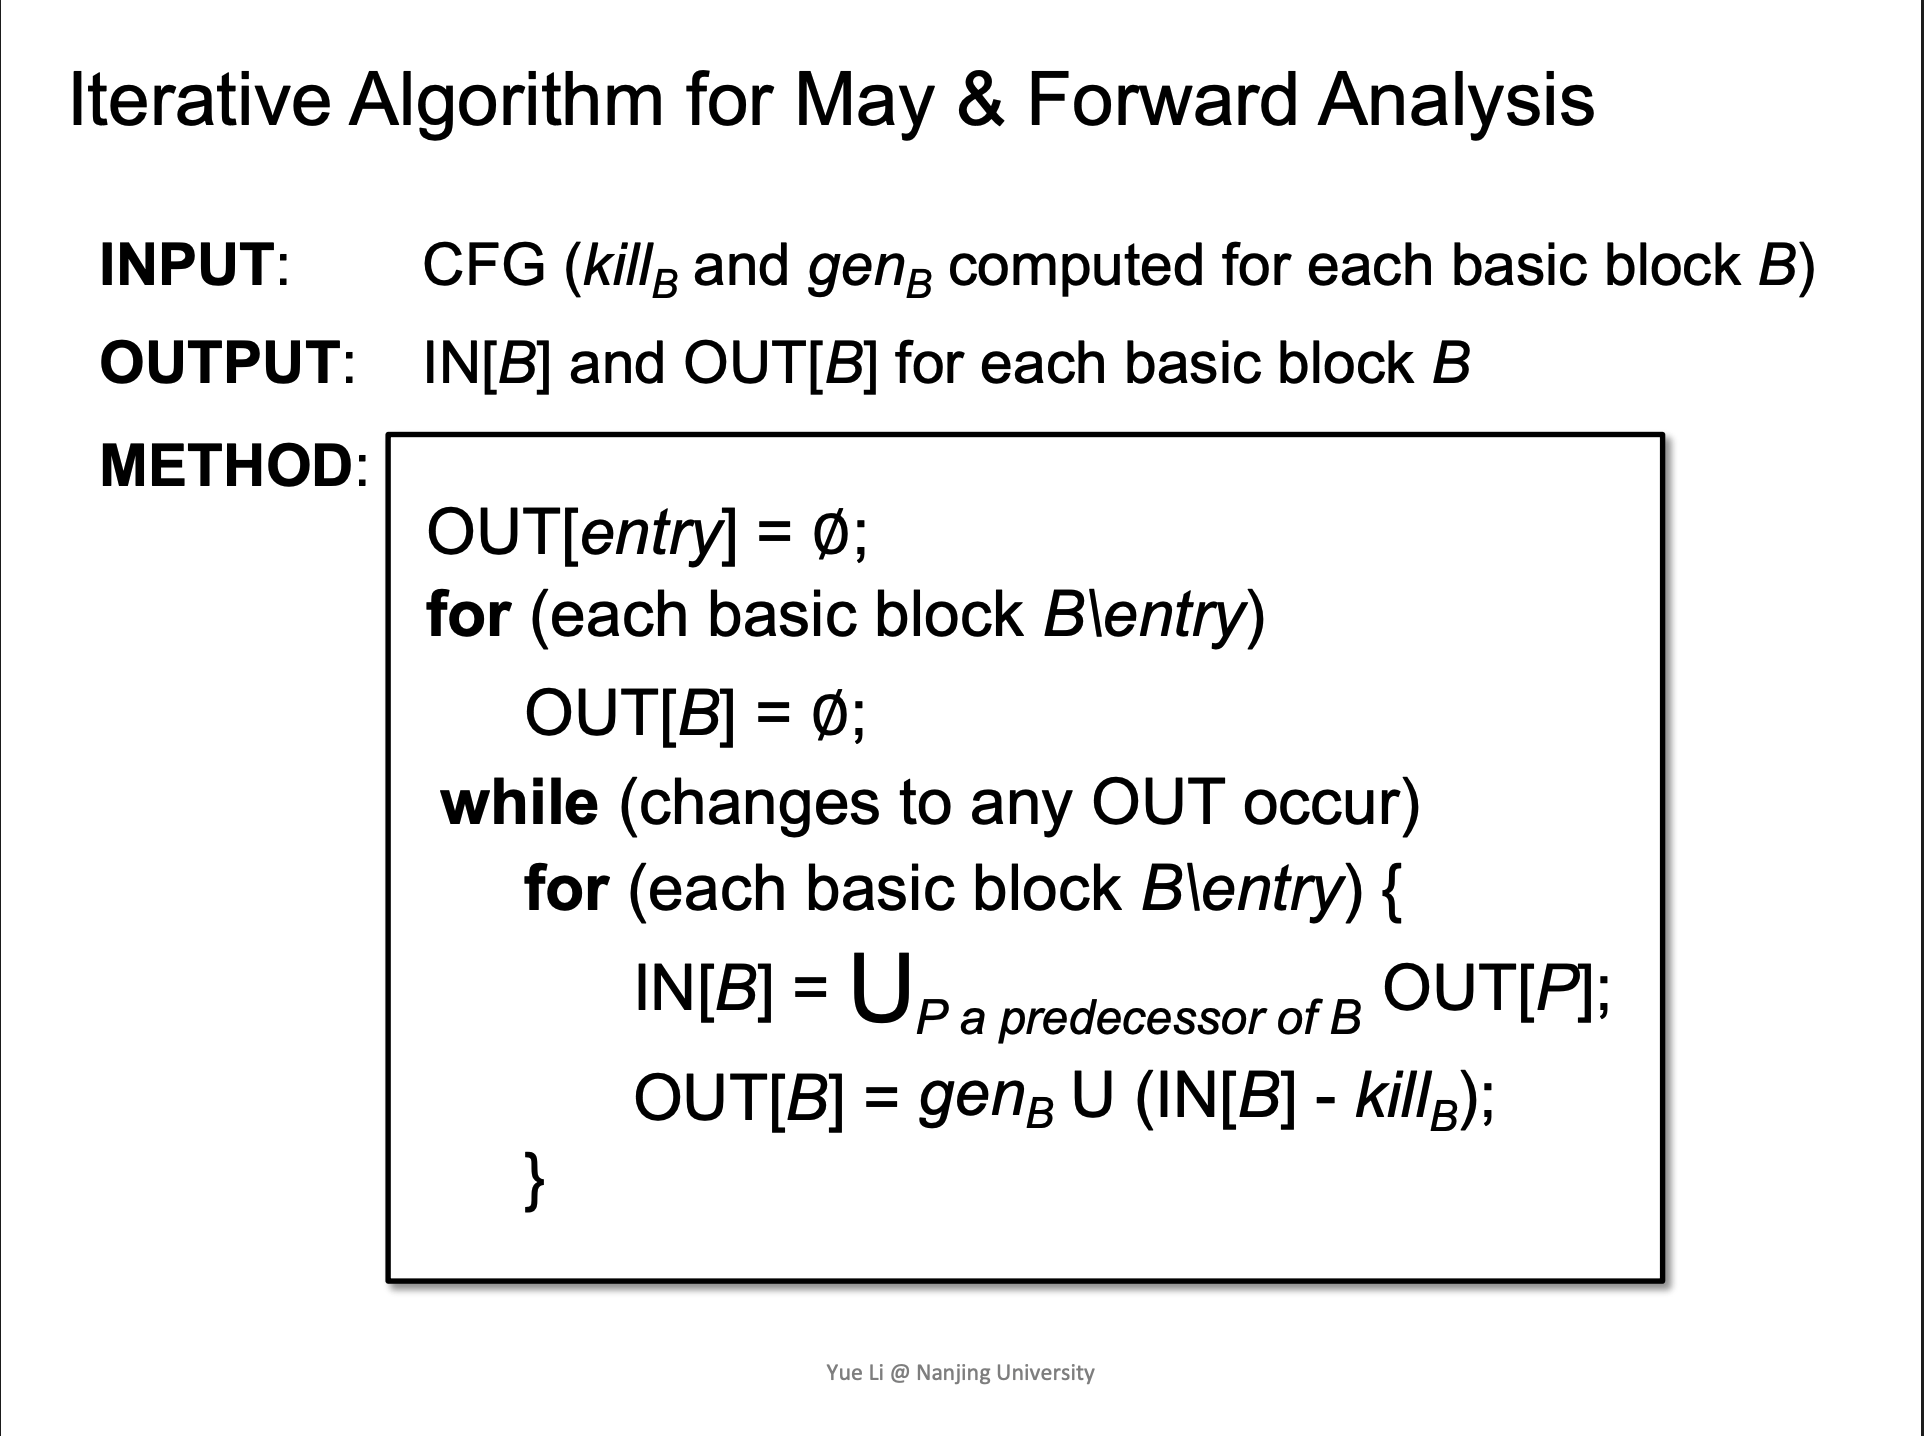
其实可以用另外一种视角来看这个算法:
给定一个 k 个节点的 CFG,每次迭代更新每个节点的 OUT[n]
我们可以定义一个包含 k 个元素的元组来表示这个 CFG 全部节点的状态 (OUT[n_1], OUT[n_2], … ,OUT[n_k])。并且设 V 为单个节点全部可能的状态(即值域),这样就可以用 (V_1 x V_2 x V_3 x …. x V_k) 即 V^k 来表示每次迭代以后的结果。
每次迭代可以视作一次通过 transfer function 和 control-flow handing 将一个 V^k 的元素映射成一个新的 V^k 中的元素的操作,可以抽象成一个函数:F: V^k -> V^k
这个算法随着迭代不断输出不同的 k-tuple,直到在上一次的 k-tuple 和这一次得出的 k-tuple 相同时中止迭代
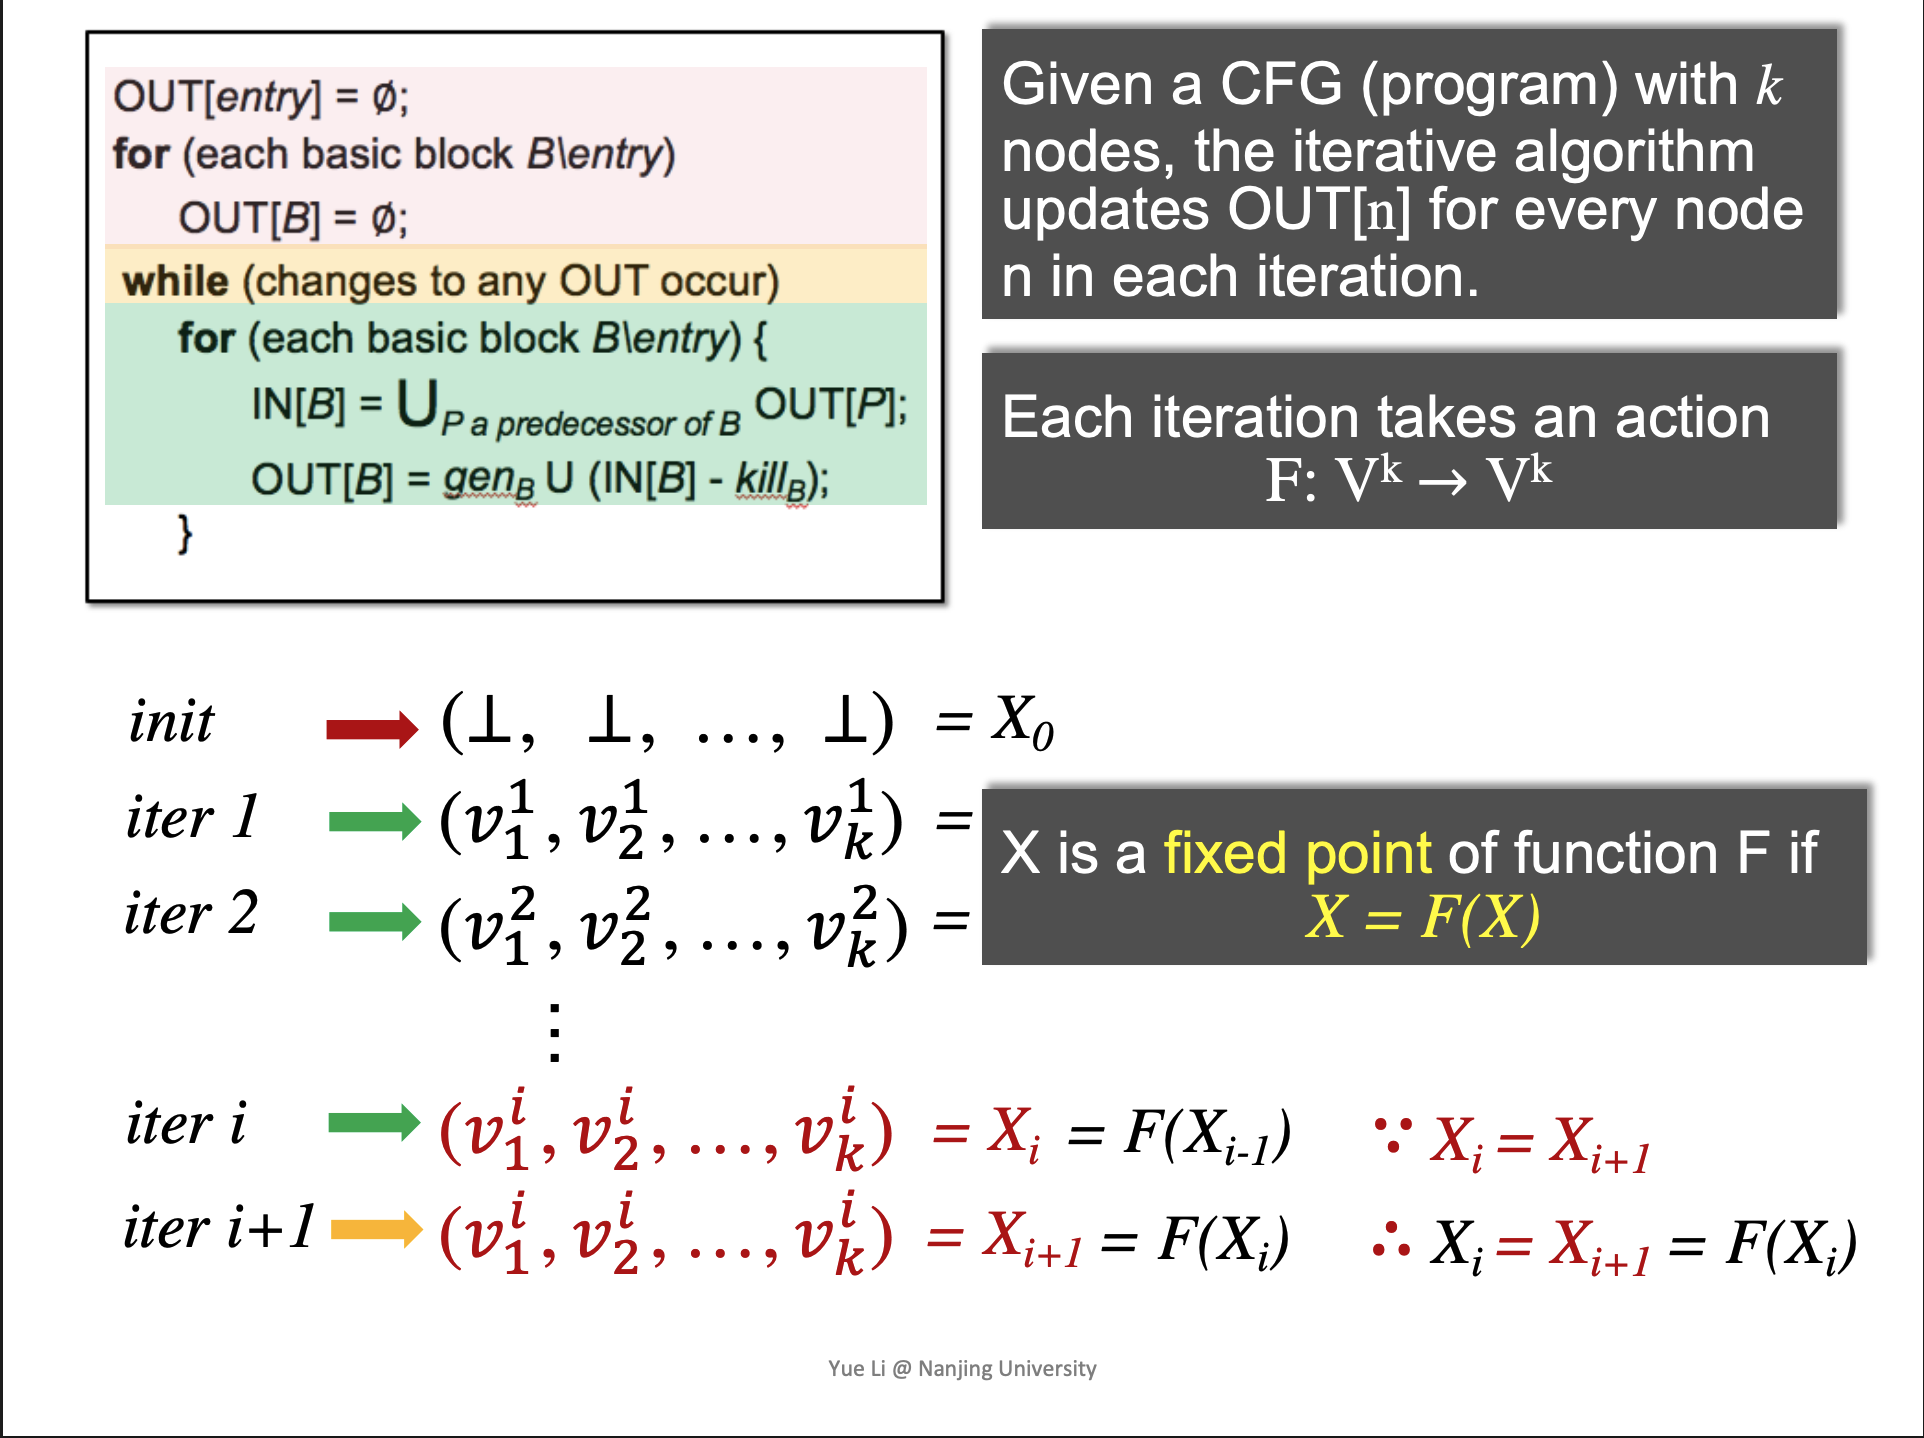
所以这个算法其实是在找一个 fixed point,那么:
这个算法是否能停机呢,也就是它是否一定能找得到一个 fixed point,它是否始终有一个解?
如果能,这个算法只有一个解吗?如果有多个,那我们求到的是不是最好(最准确)的一个?
这个算法具体在多少次迭代之后能得到一个 fixed point?
为了回答这些问题,我们得先学点数学
Partial Order
偏序关系
我们定义一个偏序集 (P, ⊑),⊑ 是一种二元关系,它在 P 上定义了一个偏序,并且 ⊑ 具有以下性质:
(1) ∀x ∈ P, x ⊑ x (Reflexivity)
- 自反性: P 中任意元素 x,都满足 x ⊑ x(自己和自己可比,且 “小于等于” 自己)。
(2) ∀x, y ∈ P, x ⊑ y ∧ y ⊑ x ⟹ x = y (Antisymmetry)
- 反对称性:若 x ⊑ y 且 y ⊑ x,则 x 与 y 必相等(不存在两个不同元素互相 “小于等于”)。
(3) ∀x, y, z ∈ P, x ⊑ y ∧ y ⊑ z ⟹ x ⊑ z (Transitivity)
- 传递性:若 x ⊑ y 且 y ⊑ z,则必有 x ⊑ z(“小于等于” 关系可传递)。
Example
小于(less than)不满足自反性(1 < 1, 2 < 2 不成立),所以小于不是一种偏序关系
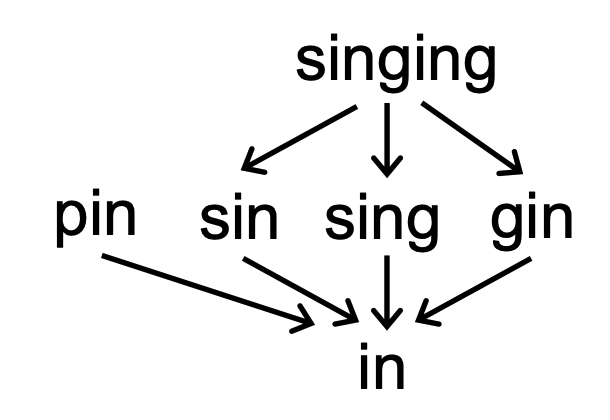
substring relation
- 满足自反性, singing 是自己的子串
- 满足反对称性,singing <= singing, singing >= singing 只在跟自身比较时可以满足
- 满足传递性,sing < singing, in < sing, in < singing
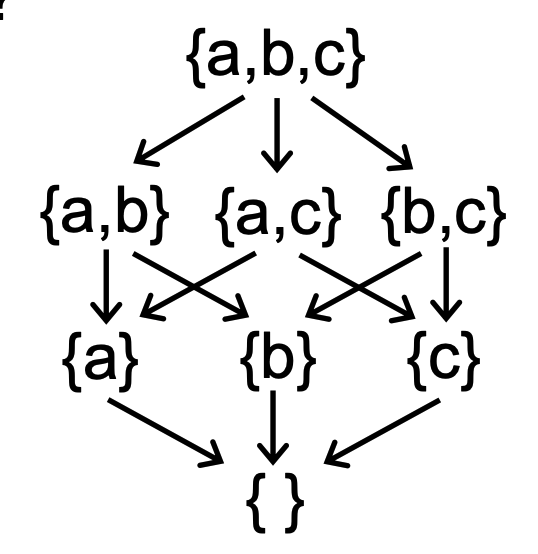
 - subset relation
- 满足自反性, set 自身也是自身的一个 subset
- 满足反对称性,彼此包含的关系只能在自身之间完成
- 满足传递性,{a, b, c} > {a, c}, {a, c} > {c}, {a, b, c} > {c}
- 满足自反性, singing 是自己的子串
Upper and Lower Bounds
给定一个偏序集 (P, ⊑),并且 S 是 P 的子集,我们认为:
如果 ∀x ∈ S, x ⊑ u ,则 u 是 S 的一个上界(upper bound)
如果 ∀x ∈ S, l ⊑ x,则 l 是 S 的一个下界(lower bound)
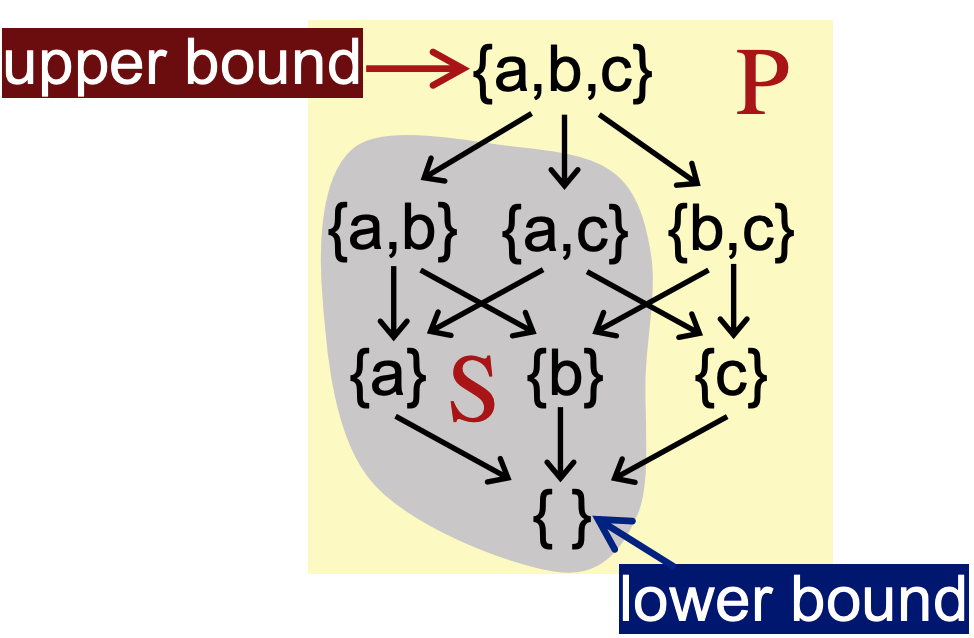
定义 S 的最小上界(least upper bound,lub or join),写作 ⊔S,其对于 S 的所有上界 u 都有 ⊔S ⊑ u。
定义 S 的最大下界(greatest lower bound,glb or meet),写作 ⊓S,其对于 S 的所有下界 l 都有 l,l ⊑ ⊓S。
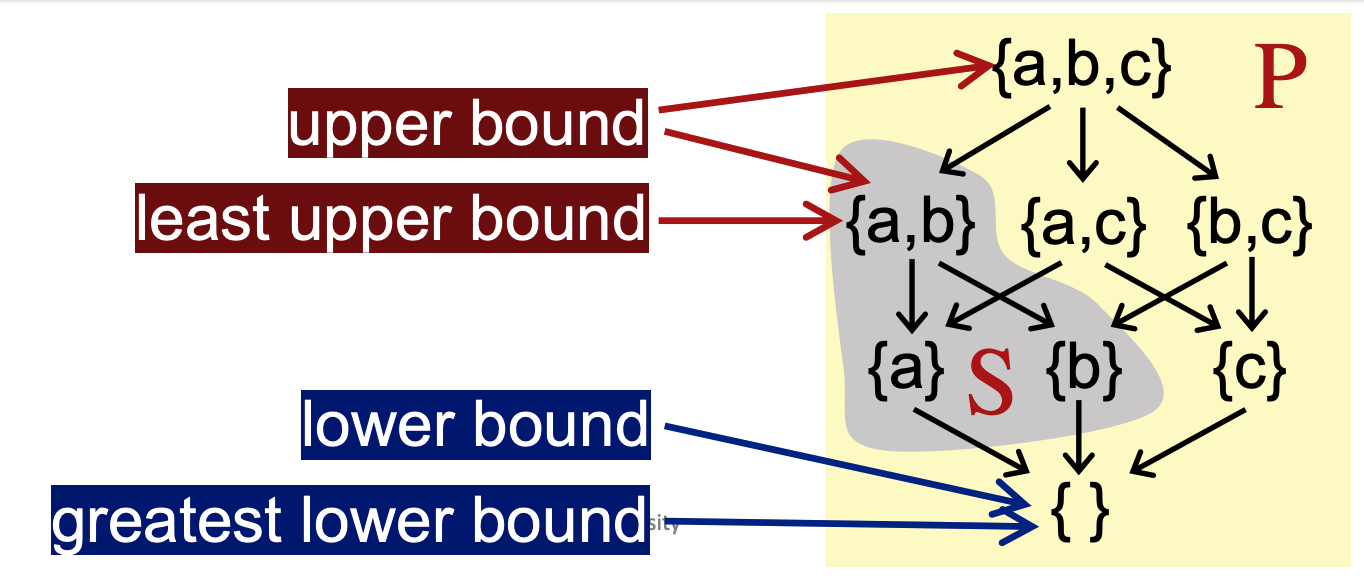
当集合 S 中只有两个元素 a 和 b 时,我们可以把它们的最小上界(lub)和最大下界(glb)用更简洁的二元运算符号来表示:
⊔S = a ⊔ b (the join of a and b)
⊓S = a ⊓ b (the meet of a and b)
并且偏序集有以下性质:
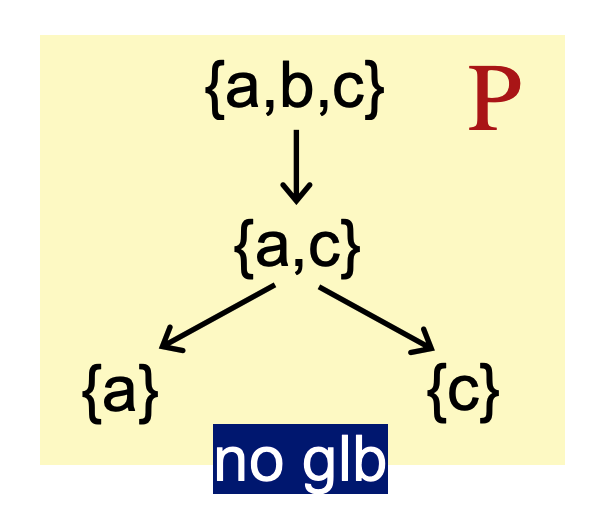
并不是所有偏序集都有 lub, glb 的
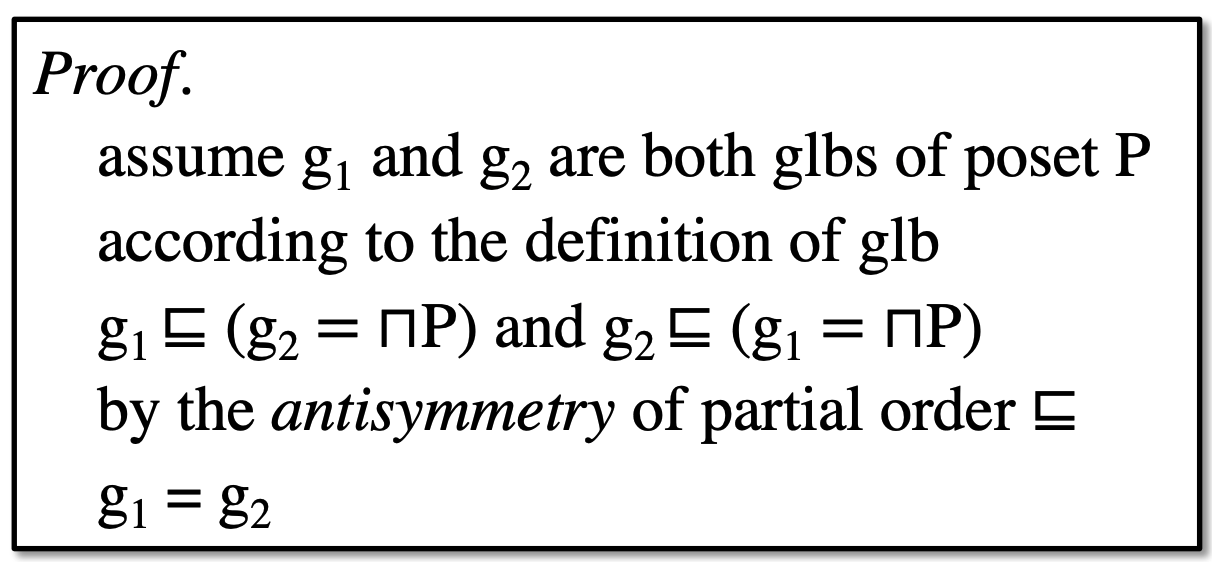
但如果有 lub 或 glb,它是唯一的
Lattice
给定一个偏序集 (P, ⊑),∀a, b ∈ P,如果 a ⊔ b 和 a ⊓ b(也就是他们的 join 和 meet)存在,那么 (P, ⊑) 就是一个 lattice。
Semilattice
给定一个偏序集(P,⊑),对于所有的 a、b∈P,若仅存在 a⊔b,则(P,⊑)被称为 join lattice
若仅存在 a⊓b,则(P,⊑)被称为 meet lattice。
Complete Lattice
在 data flow analysis 中主要关注 complete lattice
给定一个 lattice(P,⊑),对于 P 的任意子集 S,如果 ⊔S 和 ⊓S 存在,那么(P,⊑)被称为 comlete lattice。
每个 complete lattice 都有一个最大的元素 T= ⊔P 称为 top,并且有一个最小的元素 ⊥ = ⊓P 称为 bottom。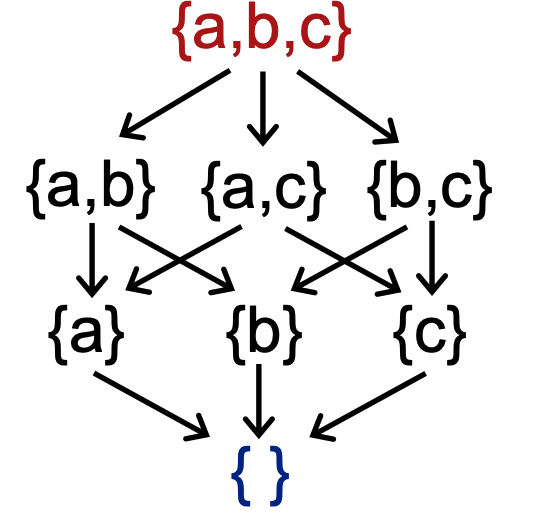
Product Lattice
给定 lattice:
$$
L_1 = (P_1, ⊑_1), L_2 = (P_2, ⊑_2),…,L_n = (P_n, ⊑_n)
$$
如果对于所有 i,(P_1, ⊑_1)既有 lub 又有 glb,然后我们就可以有一个 product lattice: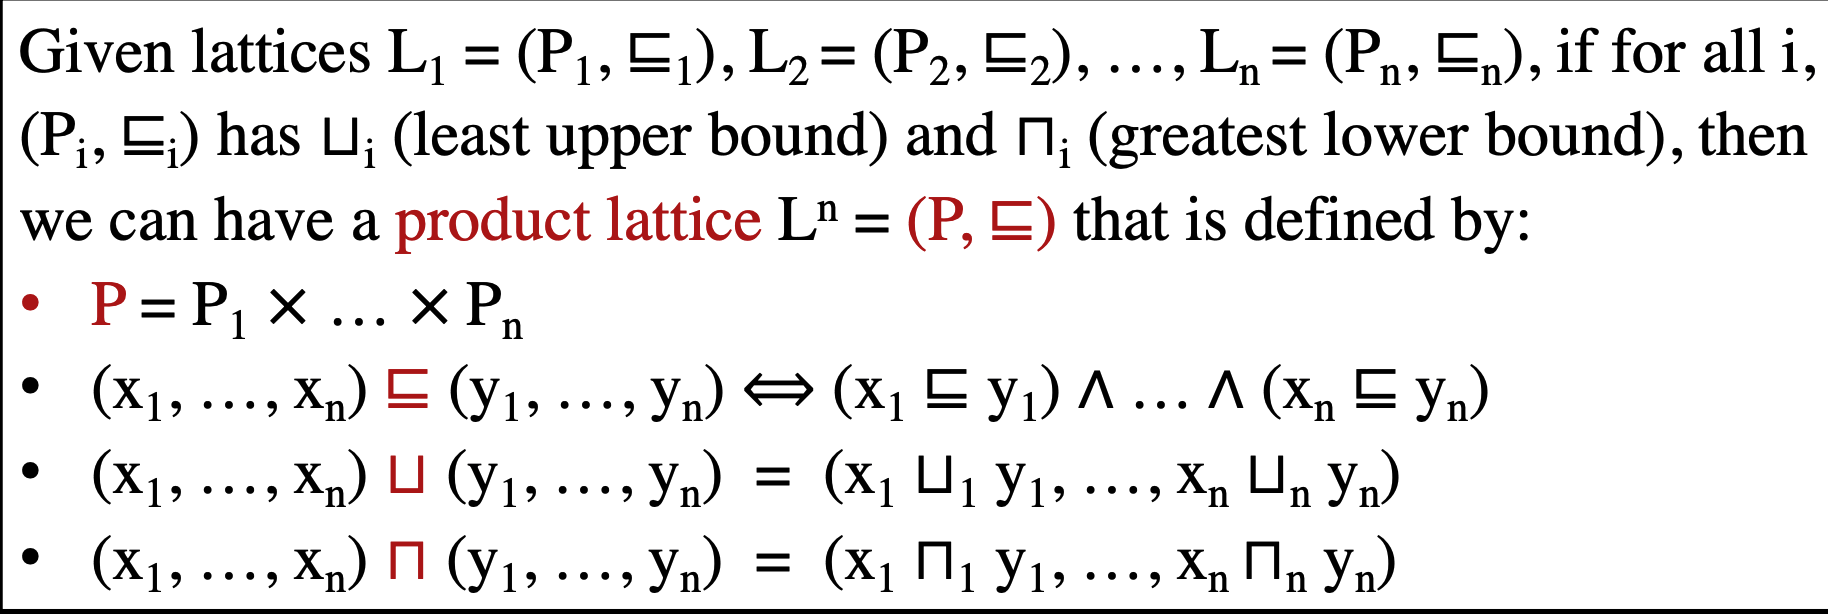
A product lattice is a lattice
If a product lattice L is a product of complete lattices, then L is also complete
Dataflow Analysis Framework via Lattice
所以一个数据流分析框架其实包含了三要素(D,L,F):
D: 分析数据流的方向 - forwards or backwards
L:一个包含所有值值域 V 的 lattice 和一个 meet 或者 join operator
F:一个映射 V 到 V 的 transfer function
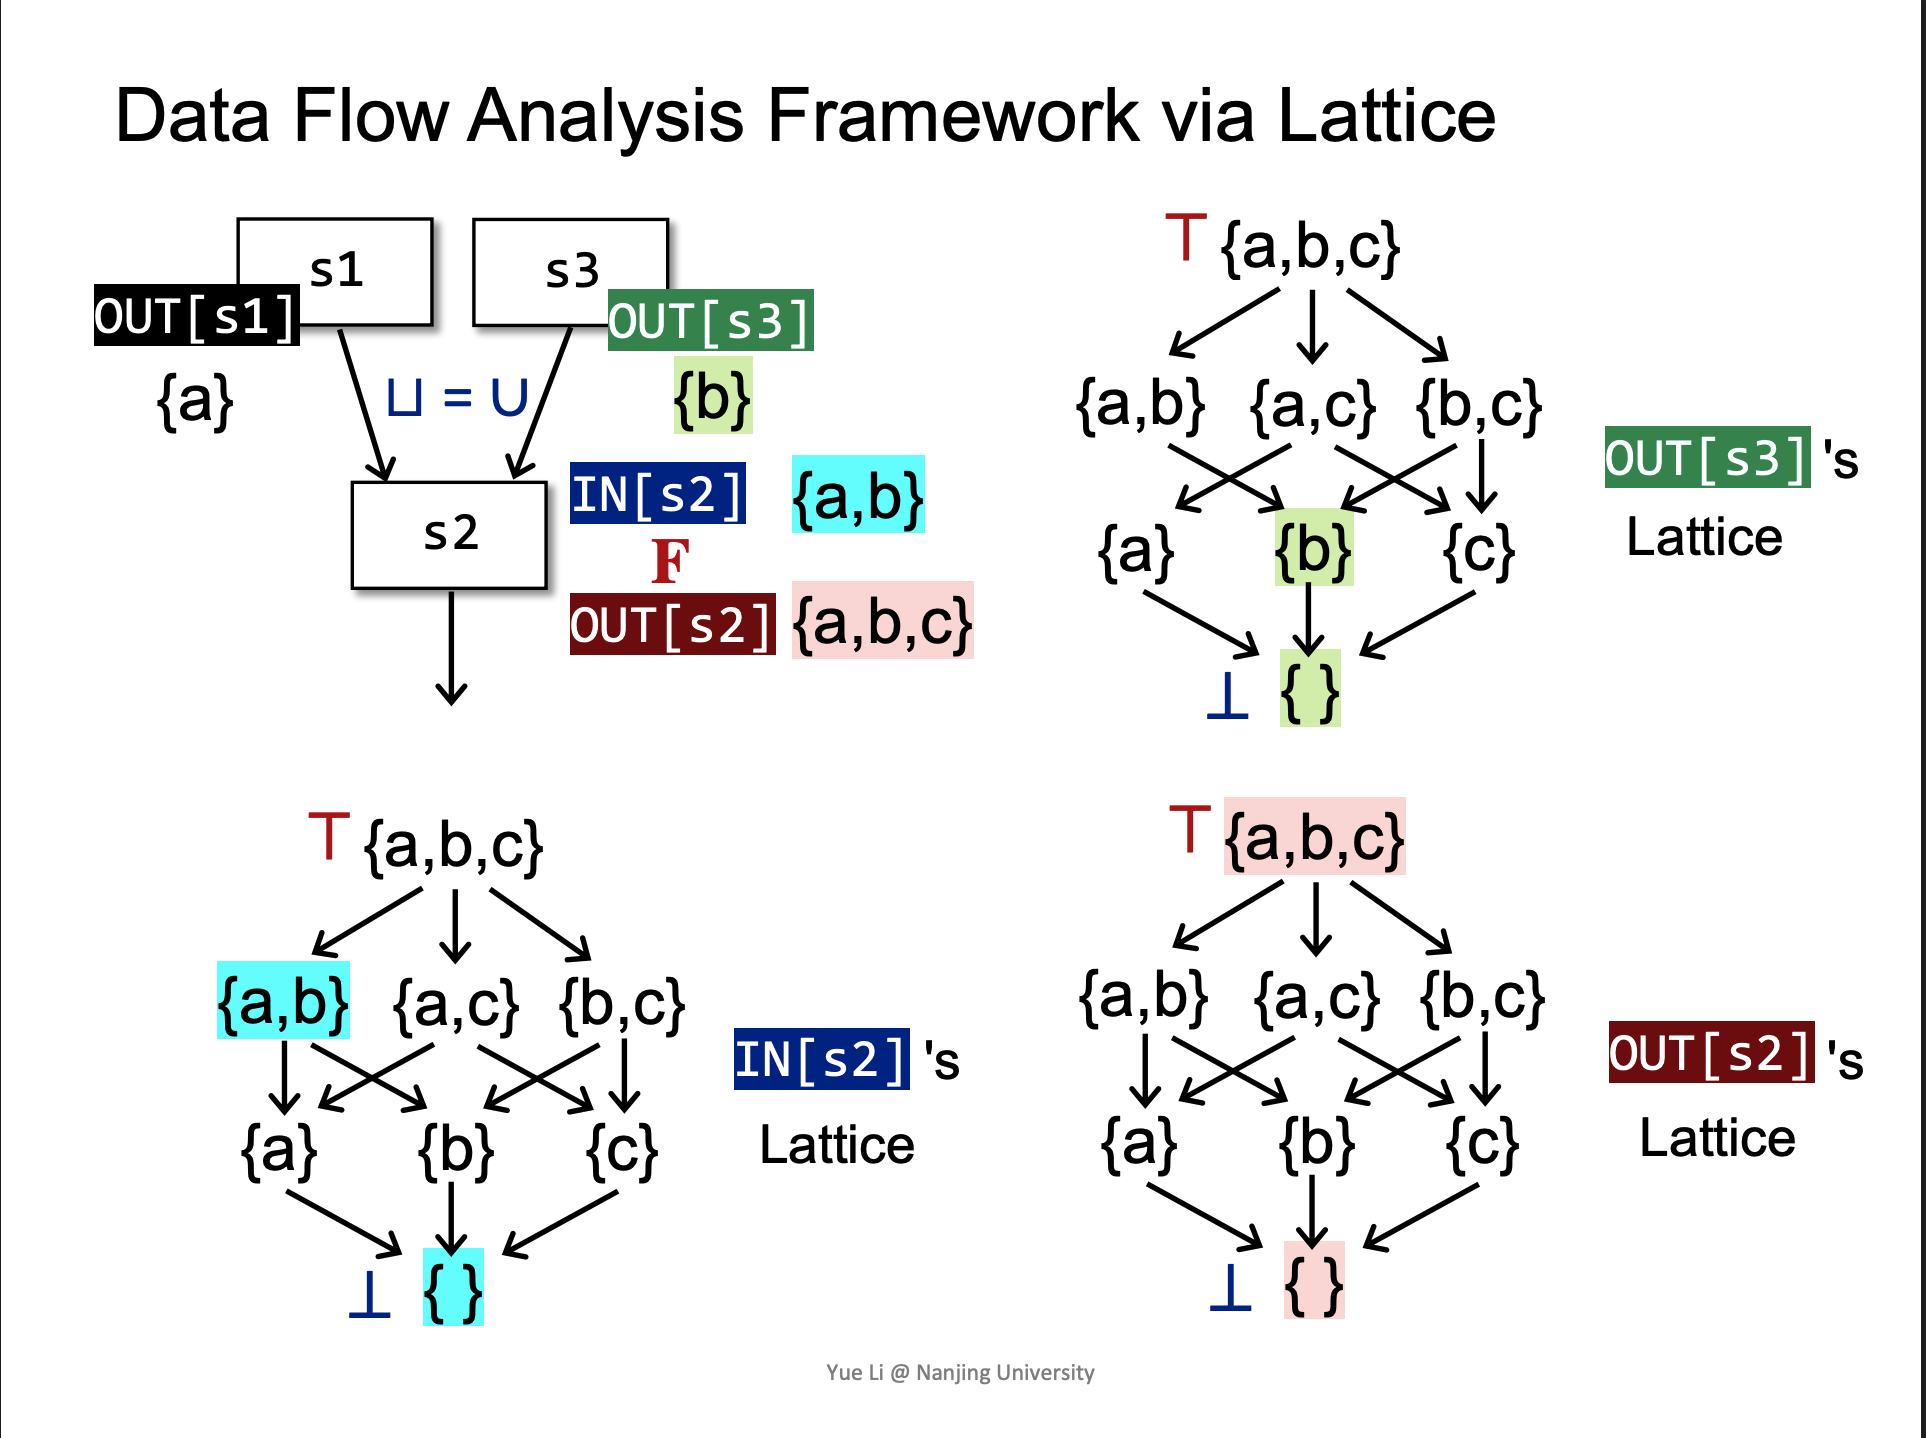
数据流分析可以视作不断迭代 apply transfer function 和 meet/join operator 到一个 lattice 的 values。
这里我们发现 OUT 是只会增加,不会减少的,因为 meet operator 是单调的,要么交,要么并。交的话就是只会增加,反之并的话就是只会减少,这就意味着算法是单调的。
Fixed-Point Theorem
再回顾我们之前提到的问题
这个算法是否能停机呢,也就是它是否一定能找得到一个 fixed point,它是否始终有一个解?
如果能,这个算法只有一个解吗?如果有多个,那我们求到的是不是最好(最准确)的一个?
我们知道一个函数单调有界的情况下,不可能无限增长/减少,一定是能得到一个极值的,所以我们就可以回答这个问题了,算法是可以停机的,一定能找到一个 fixed point,根据 Fixed Point Theorem 它也会是最好的一个 fixed point。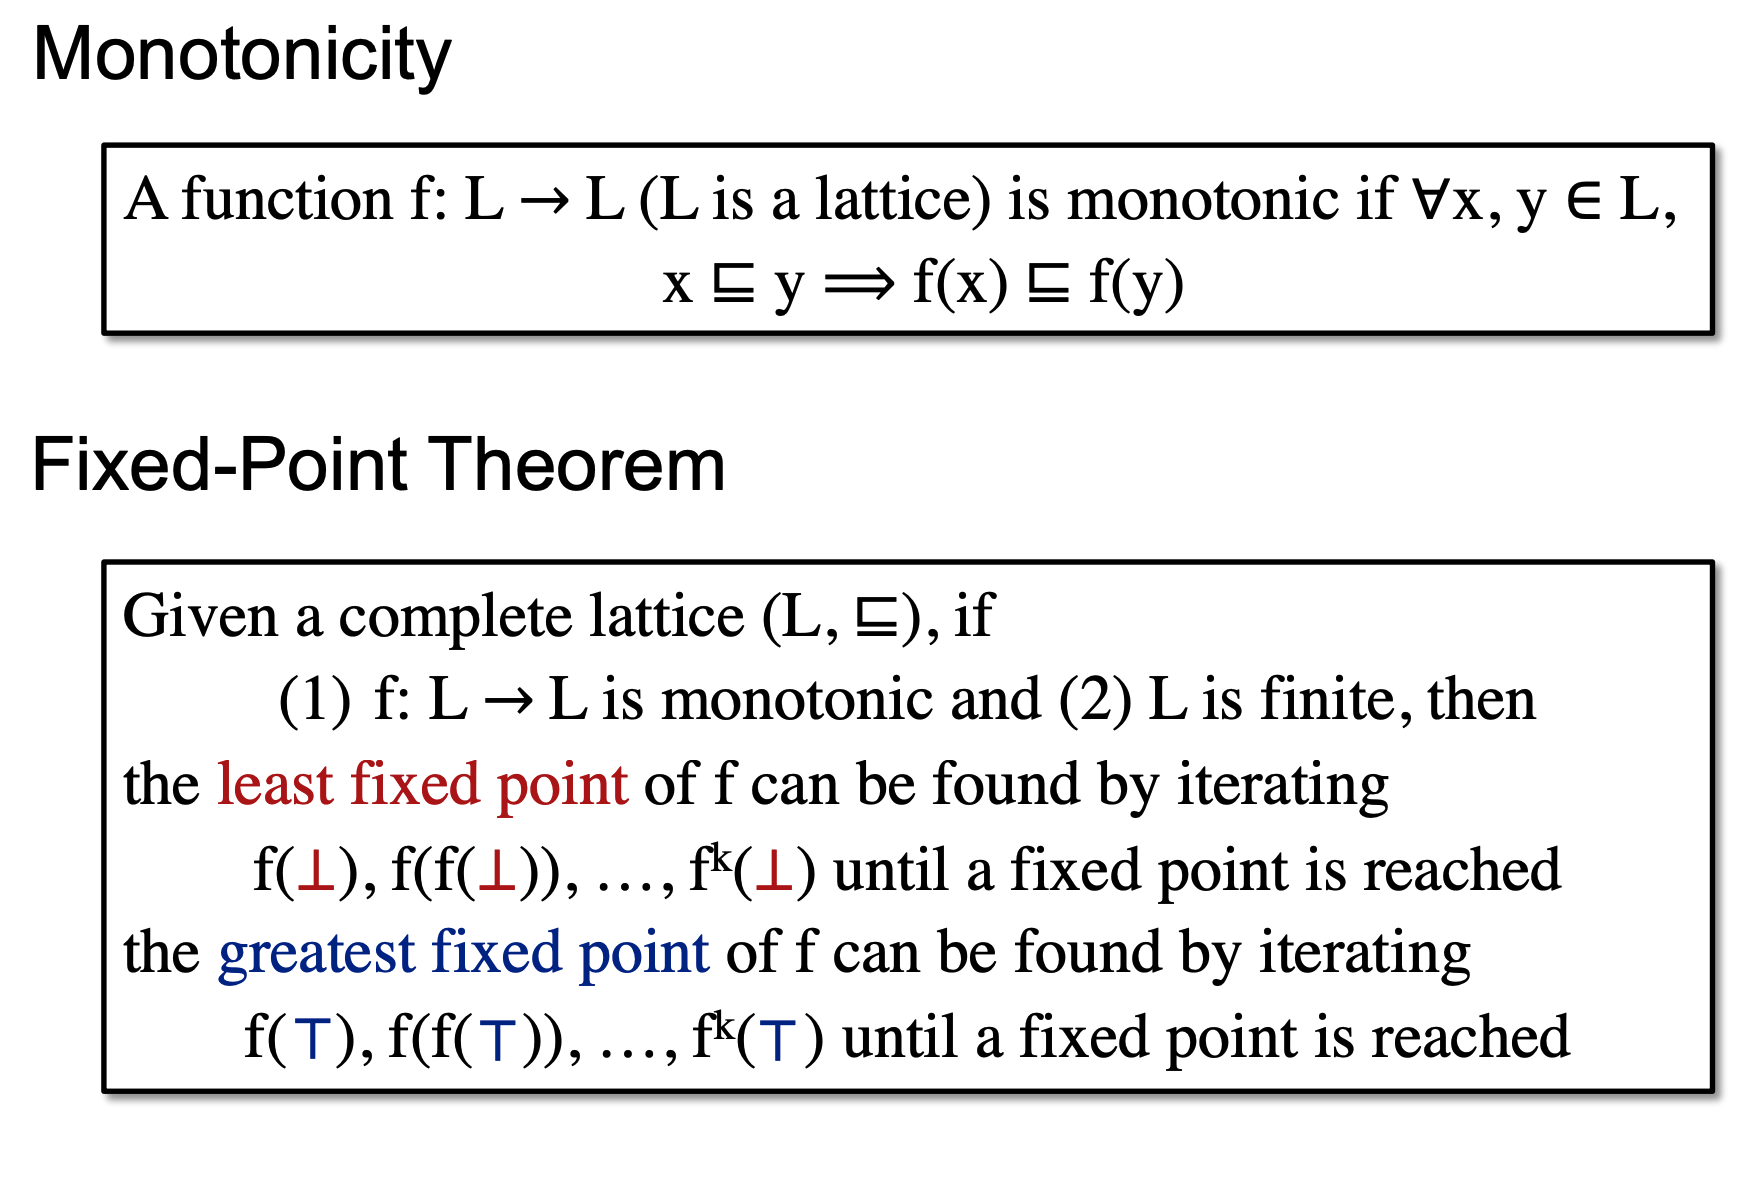
Proof
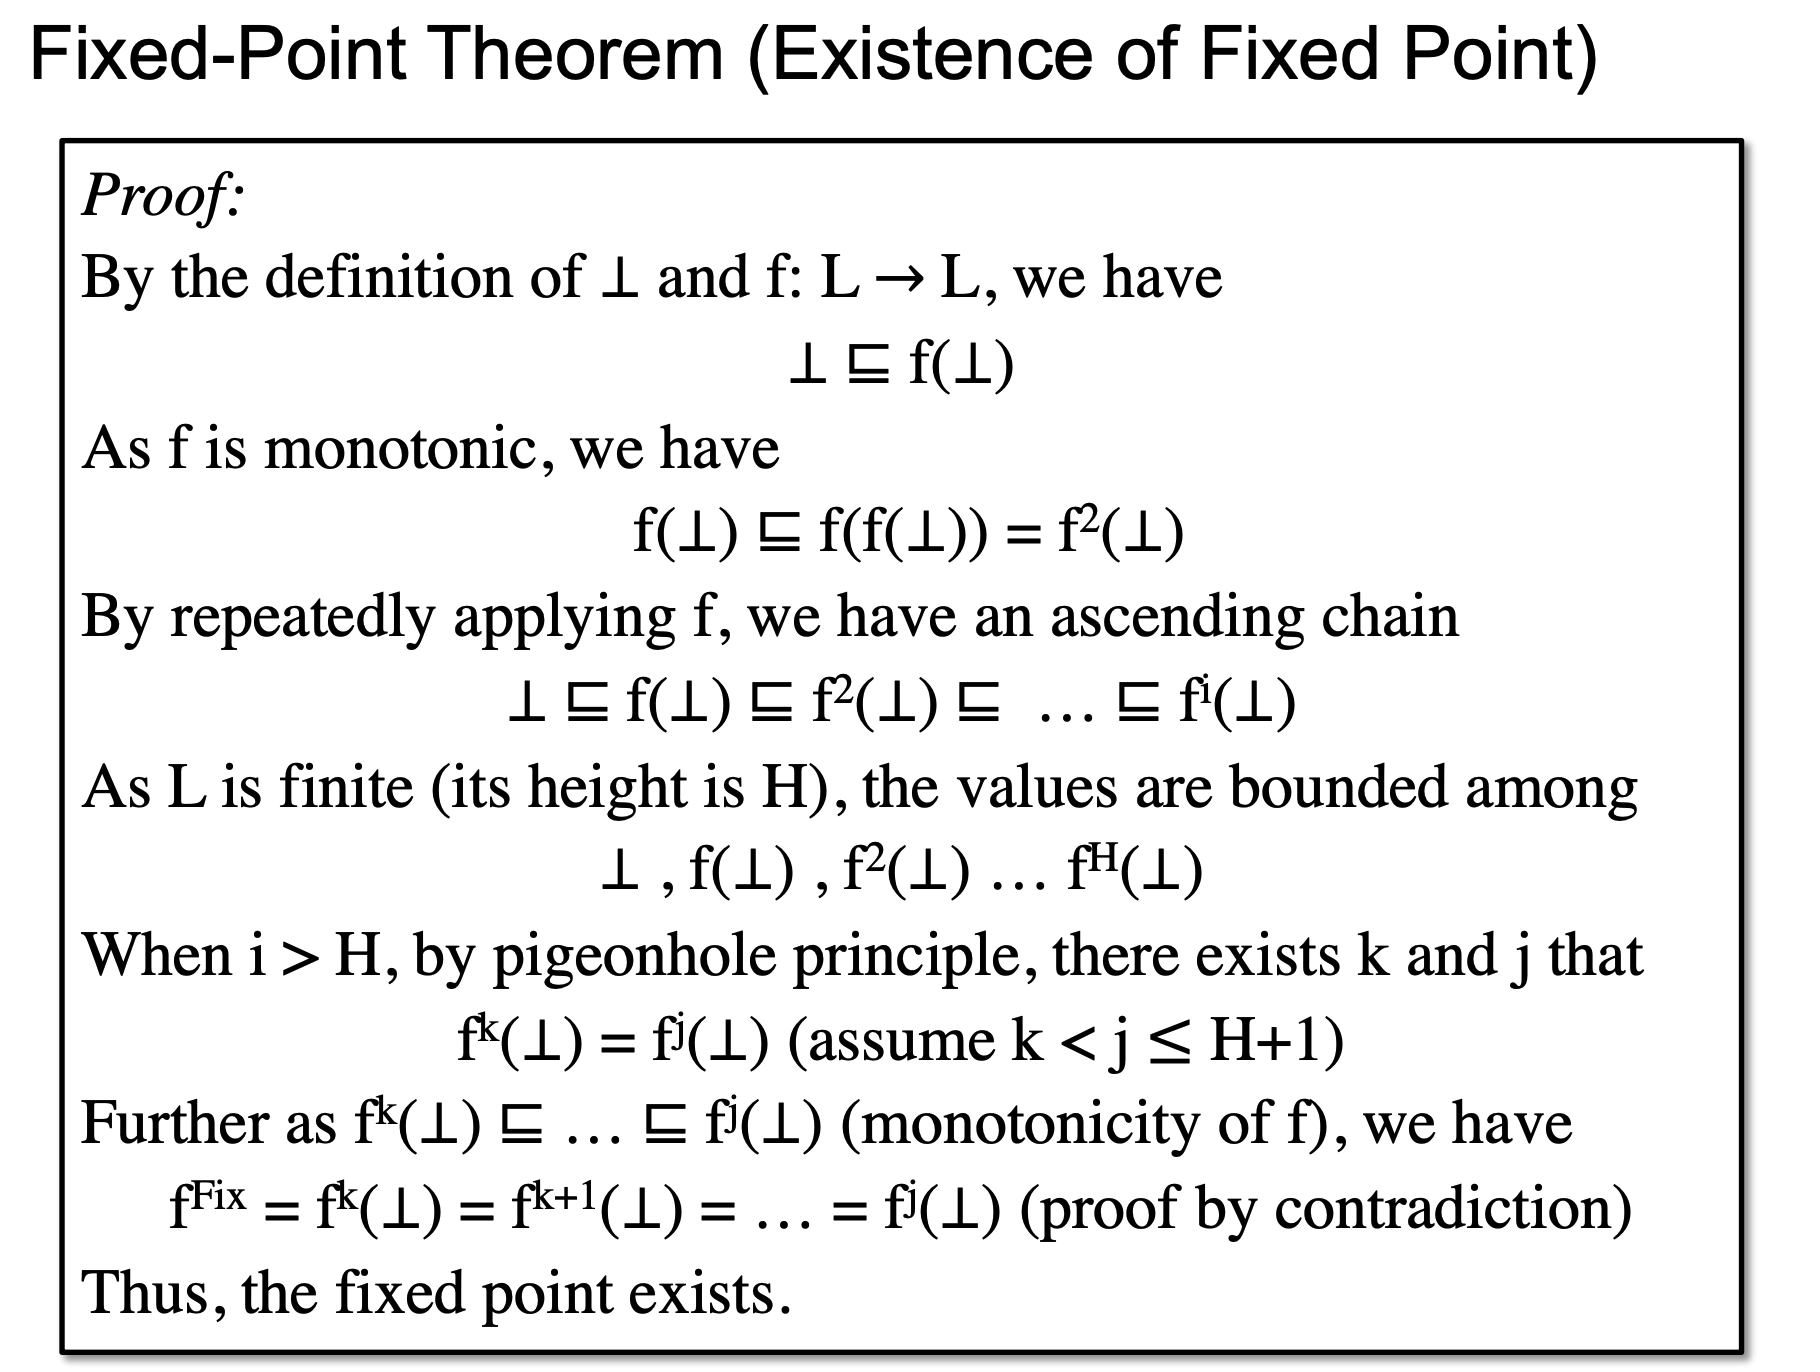
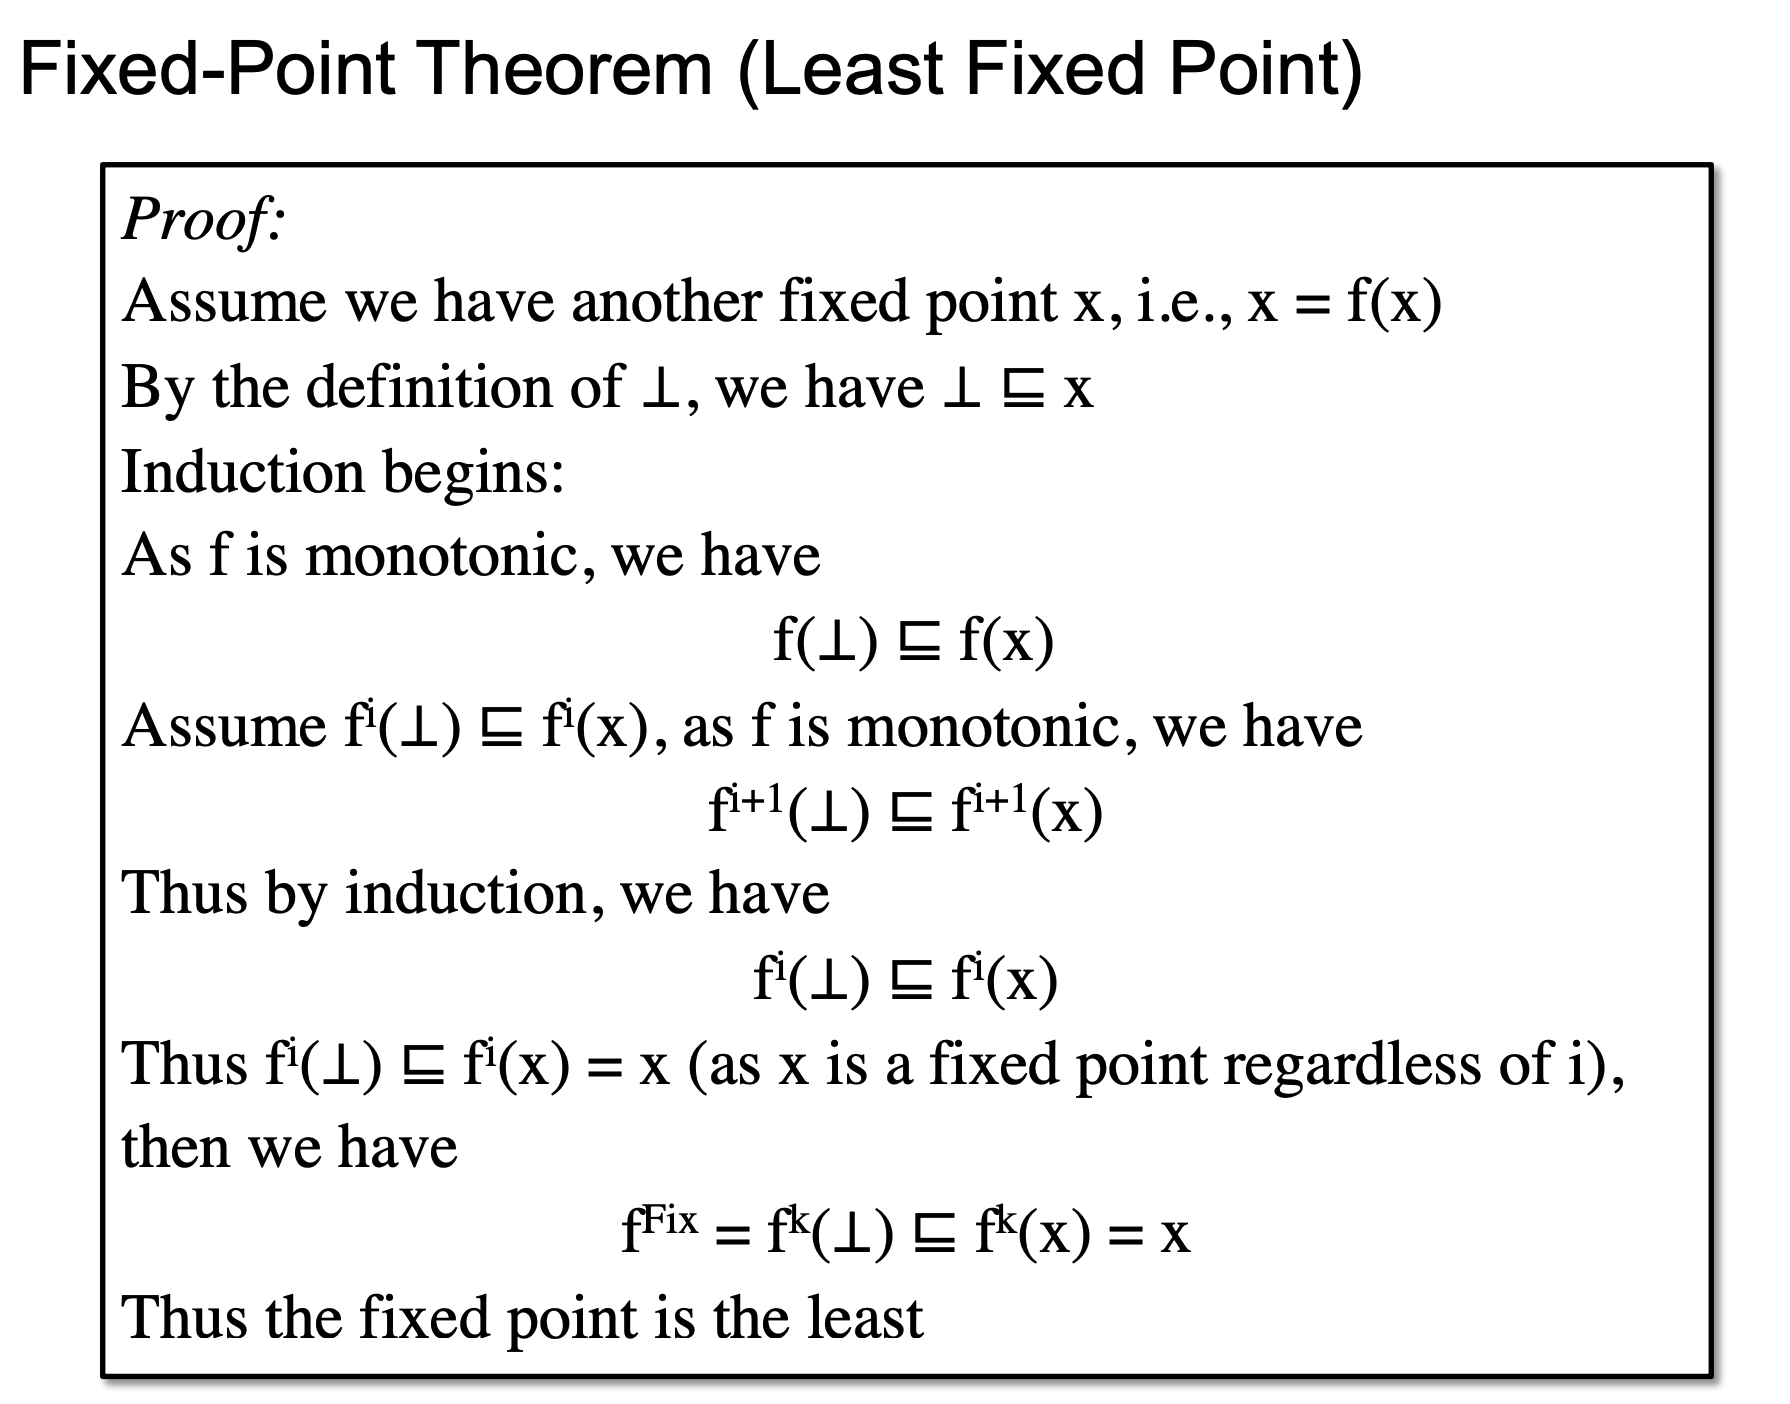
Relate Iterative Algorithm to Fixed-Point Theorem
Fixed-Point Theorem 需要满足条件,首先给定的 lattice 必须要是一个 complete lattice,并且第一, f: L -> L必须是单调的,第二 lattice 必须是有限的。
前面我们有引入 product lattice 这个概念,一堆有限的 complete lattice 的 product lattice 也是一个有限的 complete lattice。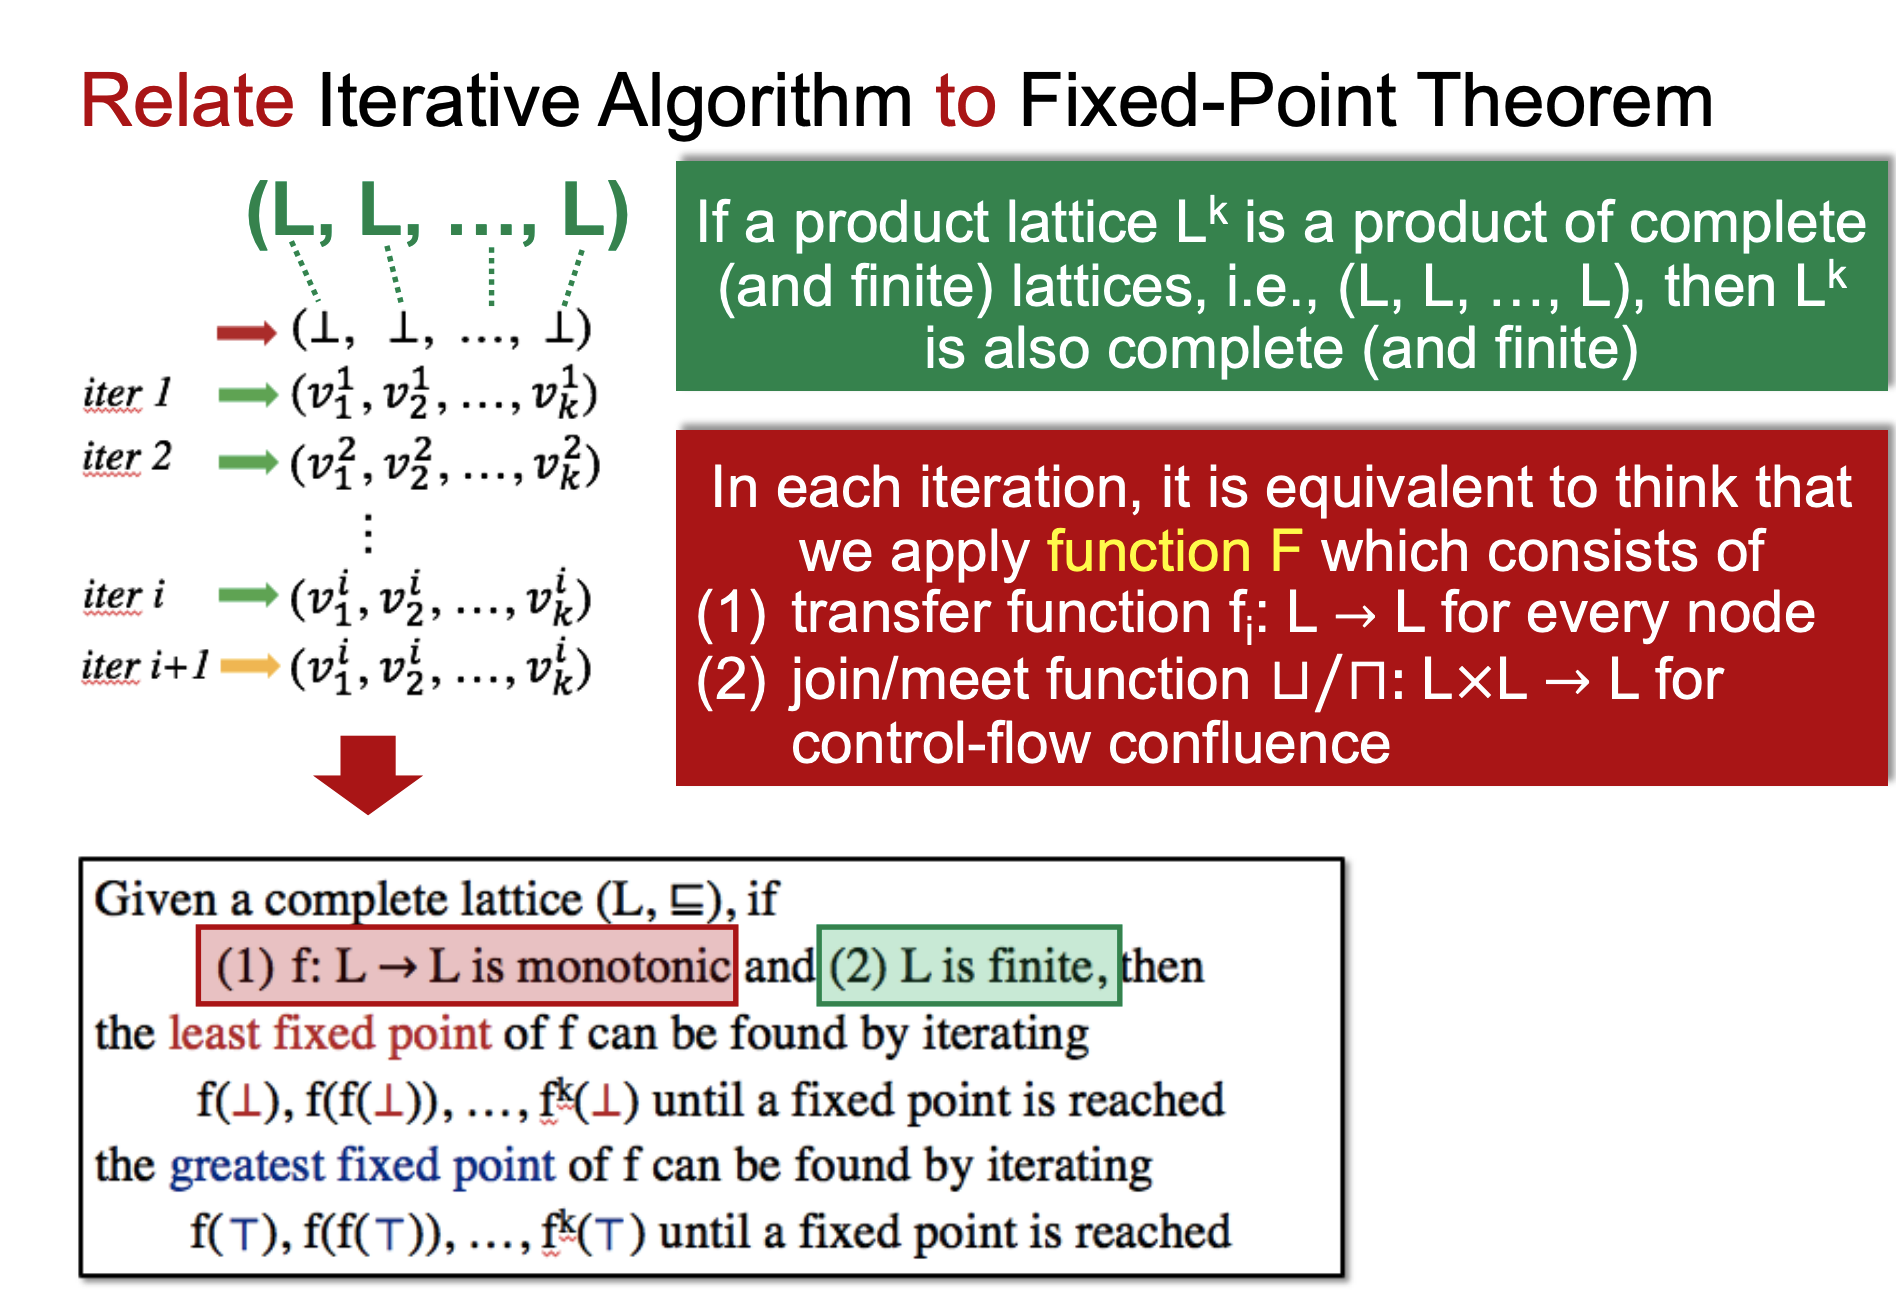
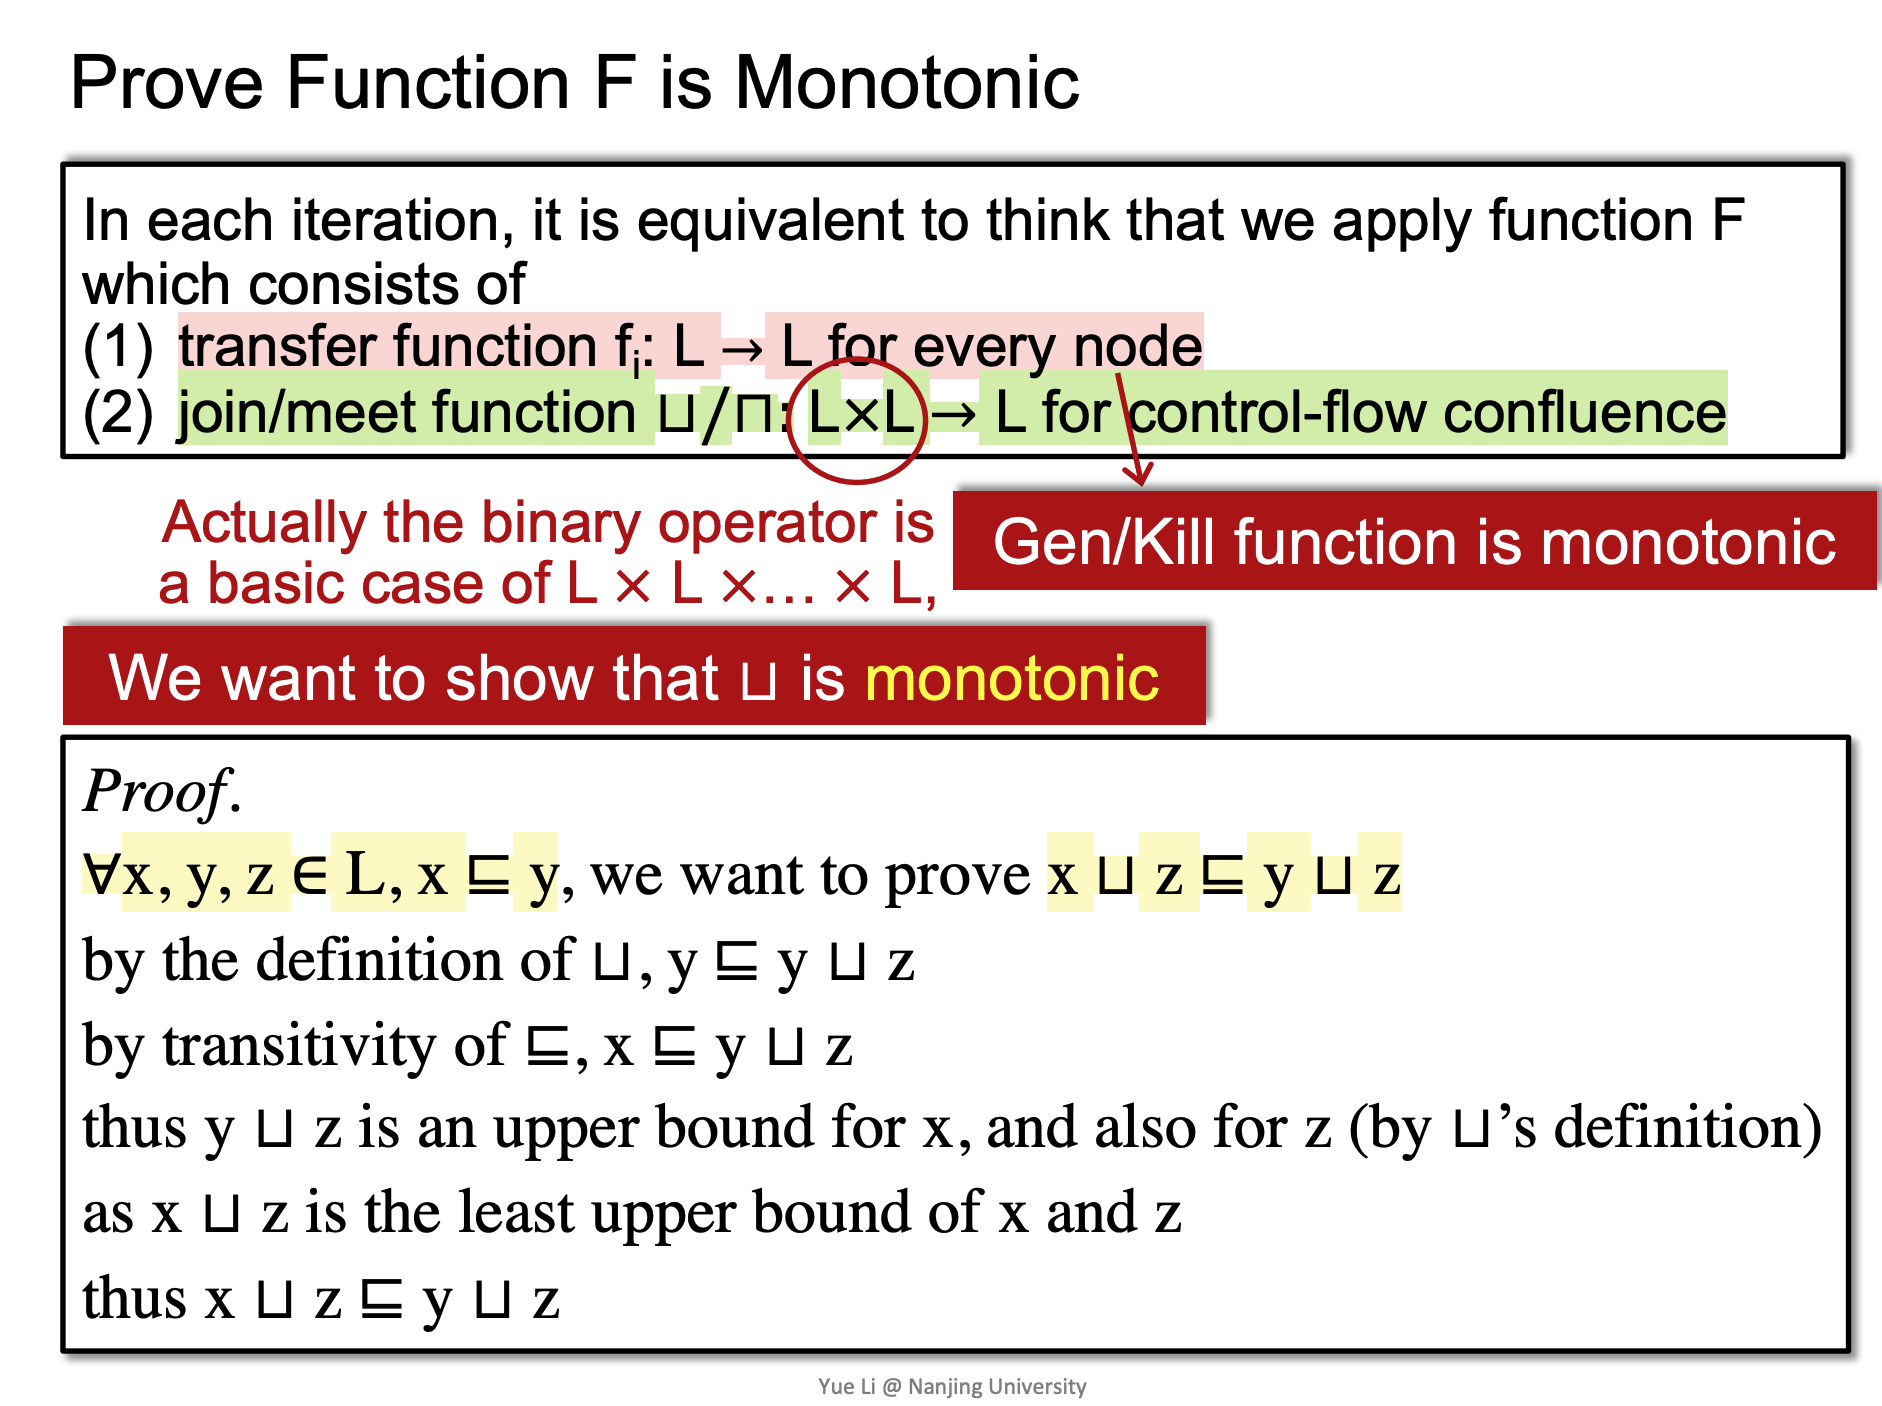
然后我们证 F 是单调的:
F 主要由 transfer function 和 join/meet function 构成,已知 transfer function 中 Gen/Kill function 都是单调的(只增加不减少),所以只需要证 join/meet function 单调即可得证 F 单调
证明步骤在下面,还是比较简单,只要能做出正确的假设。
When will the Algorithm Reach the fixed Point?
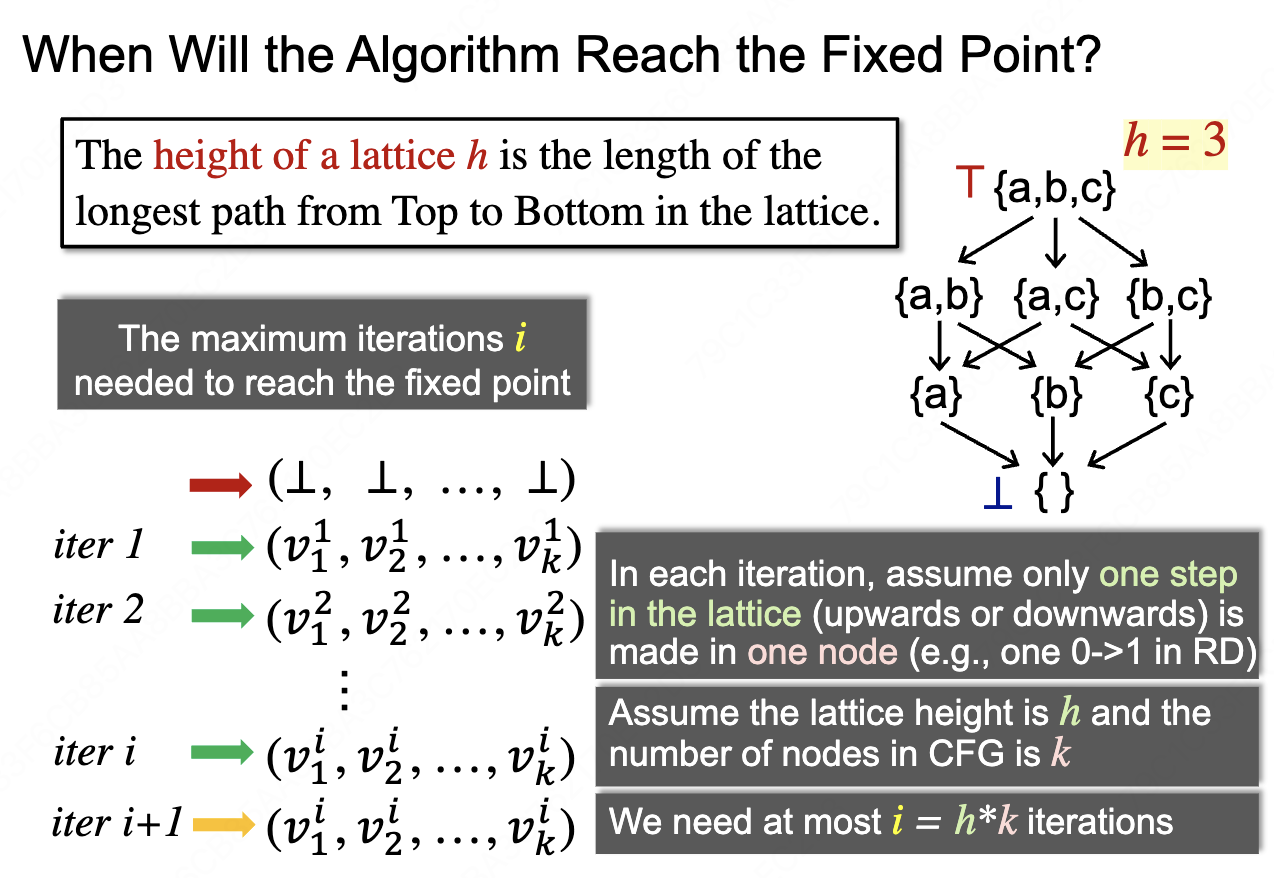
设 lattice 的高度为 h,节点数量为 k。那么我们假设每轮迭代,所有节点只有一个节点的值发生了变化,并且他在 lattice 中只移动了一步(比如 {a, b, c} -> {b, c})。这样最后达到 lub 或者 glb 的最坏可能就需要 h * k 次迭代。
May and Must Analysis, a Lattice View
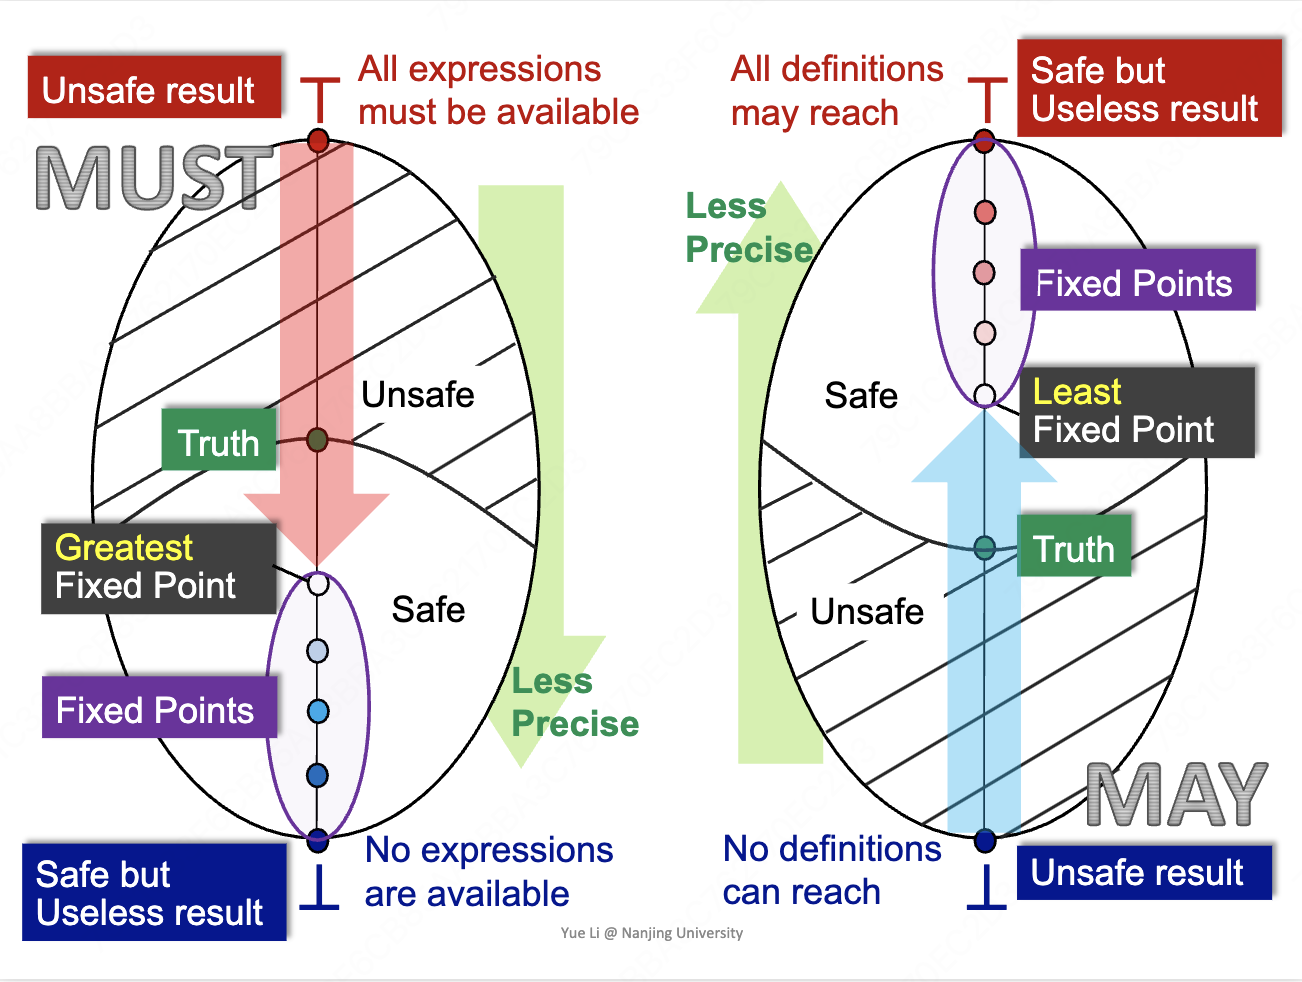
从 Lattice 的视角上看,Bottom 意味着都不满足条件,Top 意味着全部满足条件,都是从 unsafe result 去逼近 safe result,May 和 Must Analysis 的区别在于:
May Analysis:宁愿多报也不漏报,所以报得比 Truth 多的部分是 safe 的。
Must Analysis:宁愿少报也不错报,所以报得比 Truth 少的部分是 safe 的。
MOP algorithm
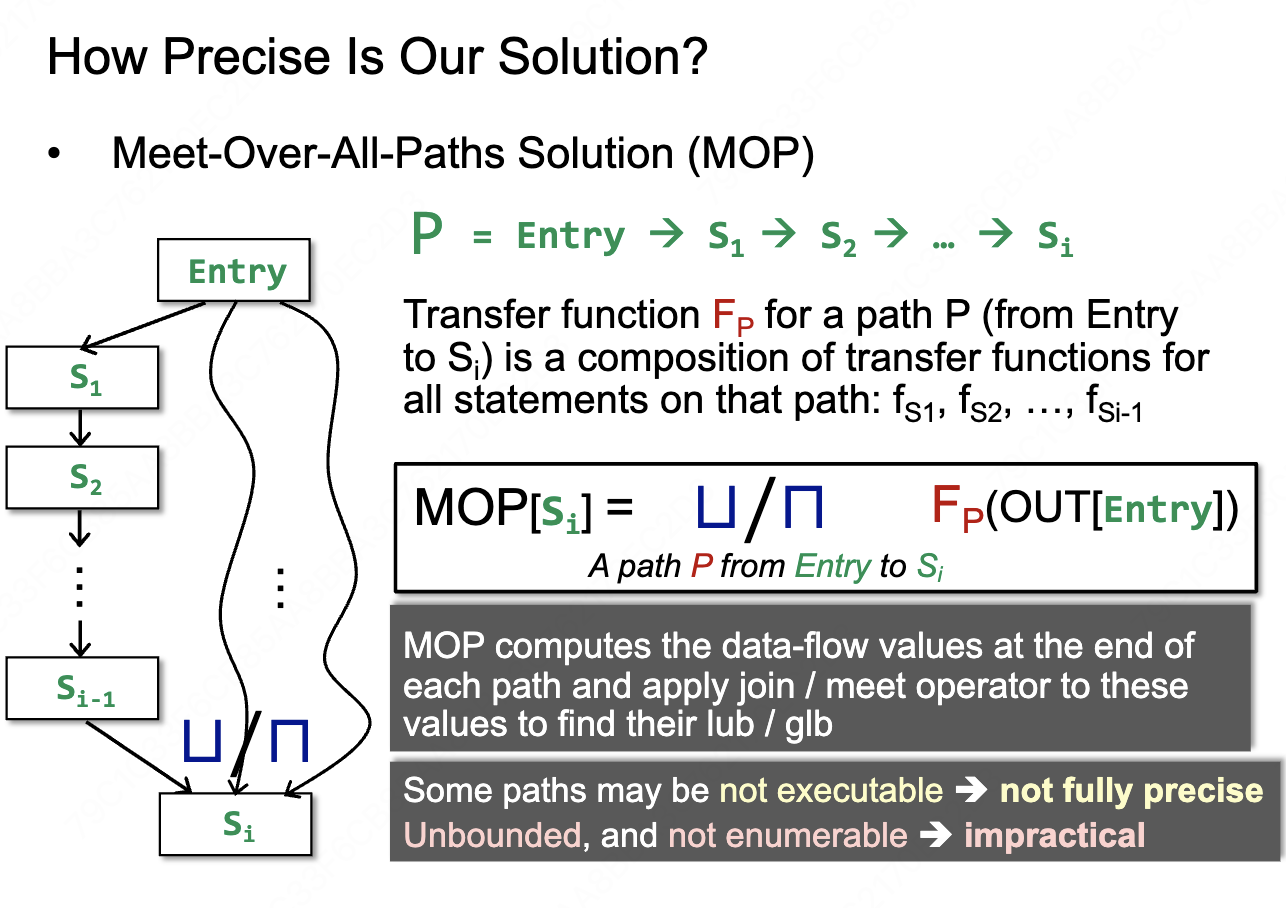
MOP(Meet-Over-All-Paths) 的核心逻辑是不要在中间合并信息,而是把每一条可能的路径都单独算到底,最后再一起合并。MOP 算法是理想的,它在实际中往往无法直接计算,但它通常被用来衡量其他数据流分析算法的精度。
MOP 并非完全精确,因为它会把有些不会执行的分支也给算进去(比如 if,它 true 和 false 的分支都会走)
MOP 实际上是 Impractical(不可计算的),Unbounded and not enumerable。比如如果程序中有循环/递归,路径的数量就是无限的。
Iterative VS. MOP
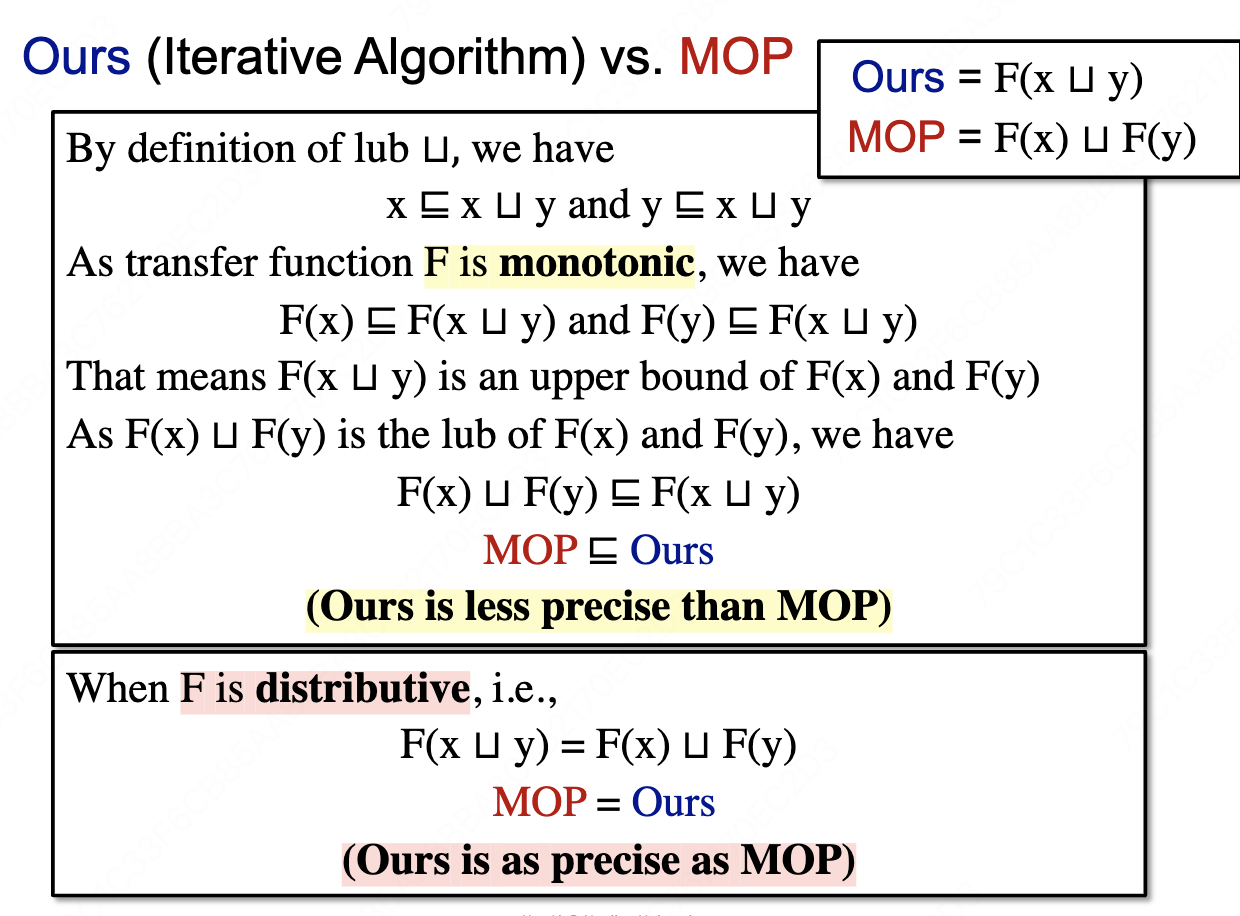
在 F 满足分配律的情况下,Iterative 算法的准确度跟 MOP 的一样好。
我们之前讨论的 Bit-vector / Gen/Kill 这种形式的 F 都是满足分配率的
但实际上也有一些 analyses 的 F 是不满足分配律的
Constant Propagation
常量传播
给定一个在程序点 p 的变量 x,x 是否保证在 p 的值是一个恒定的值。
一个数据流分析框架包含三要素:
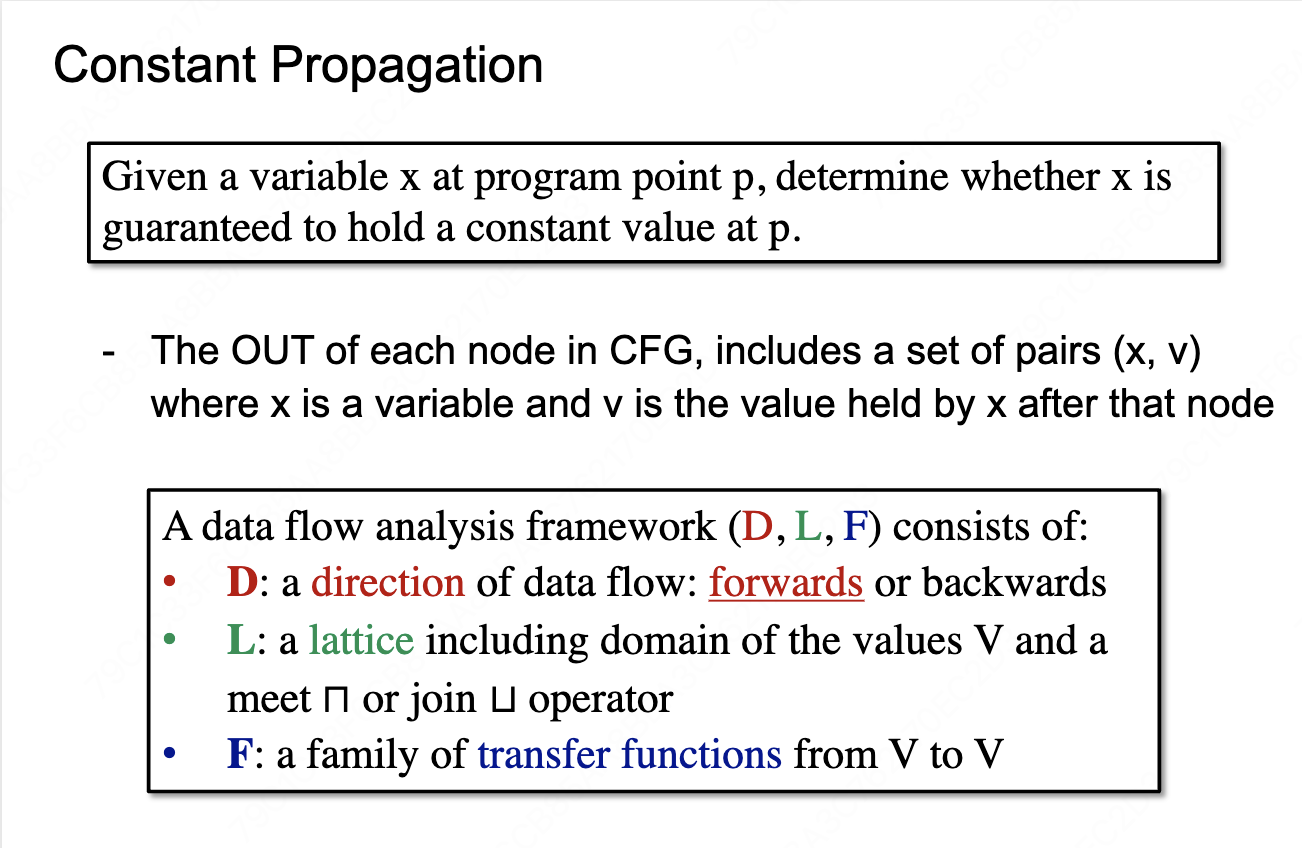
D:分析数据的方向:forwards,backwards
L:包含值的值域的 lattice,还有 meet(glb) 和 join(lub) operator。
F:将值域转换到另一个值域的 transfer functions
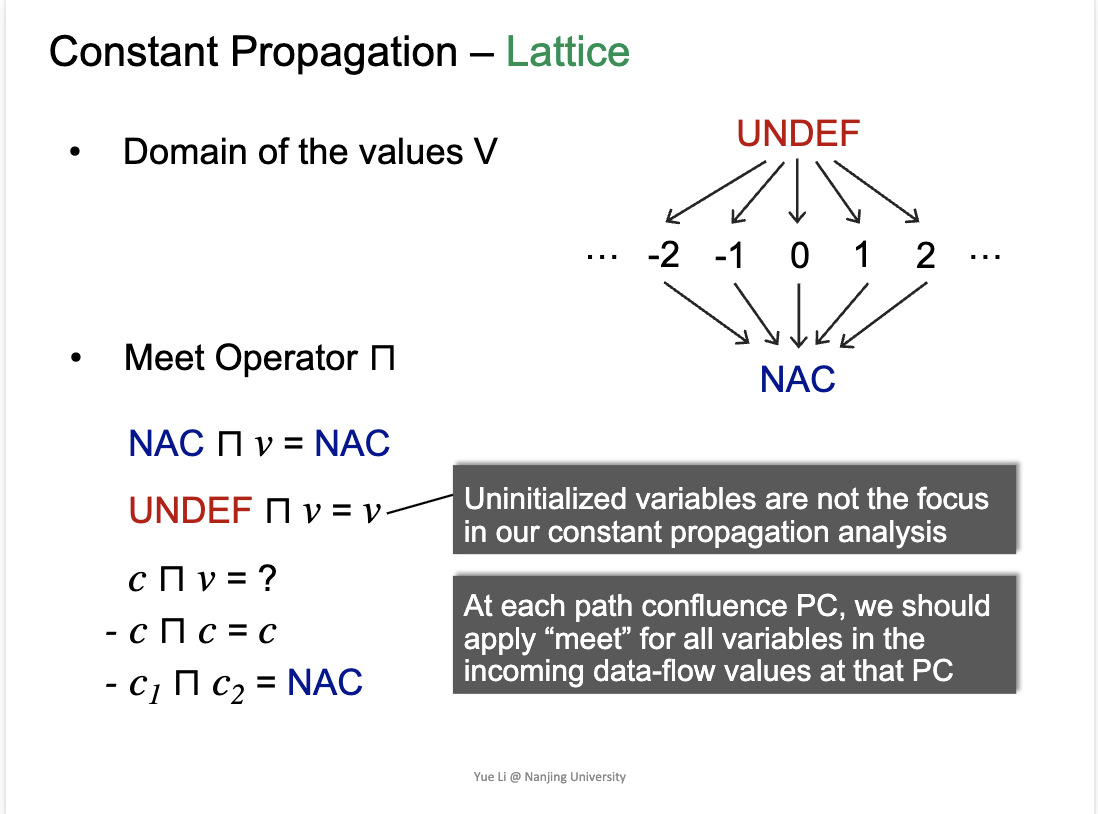
我们尝试从 lattice 的视角对问题进行建模,我们将状态区分为 UNDEF <constant> NAC 三类。
UNDEF 为初始状态,可以理解为空集,所有变量最初定义但还没赋值的时候就是这个状态。
而 NAC 则代表这个变量有两个及以上可能的值,这也就意味着这个 variable 不是常量,所以是结束状态。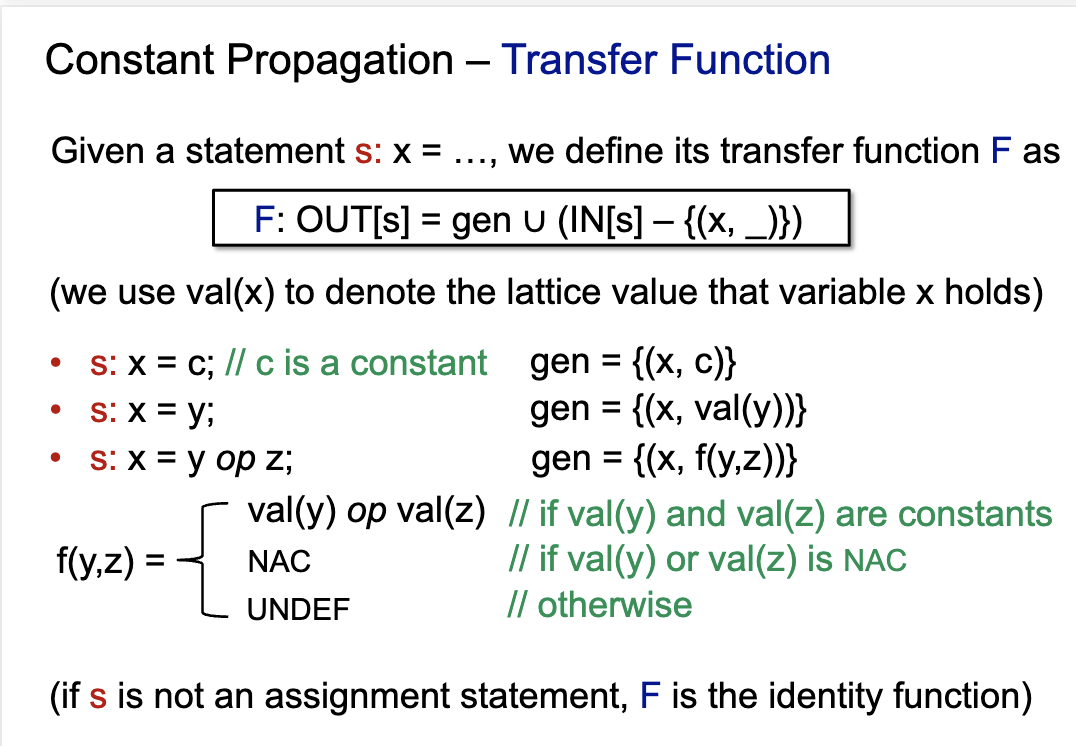
给定一个 statement,我们定义它的 transfer function F,gen 集即给 x 赋的值,如果赋值是一个表达式,如果里面的变量全为常量,则认为这个值也是常量。
输出集即 gen 集和输入集取交集,如果之前包含 x 的旧值记录则需要去掉。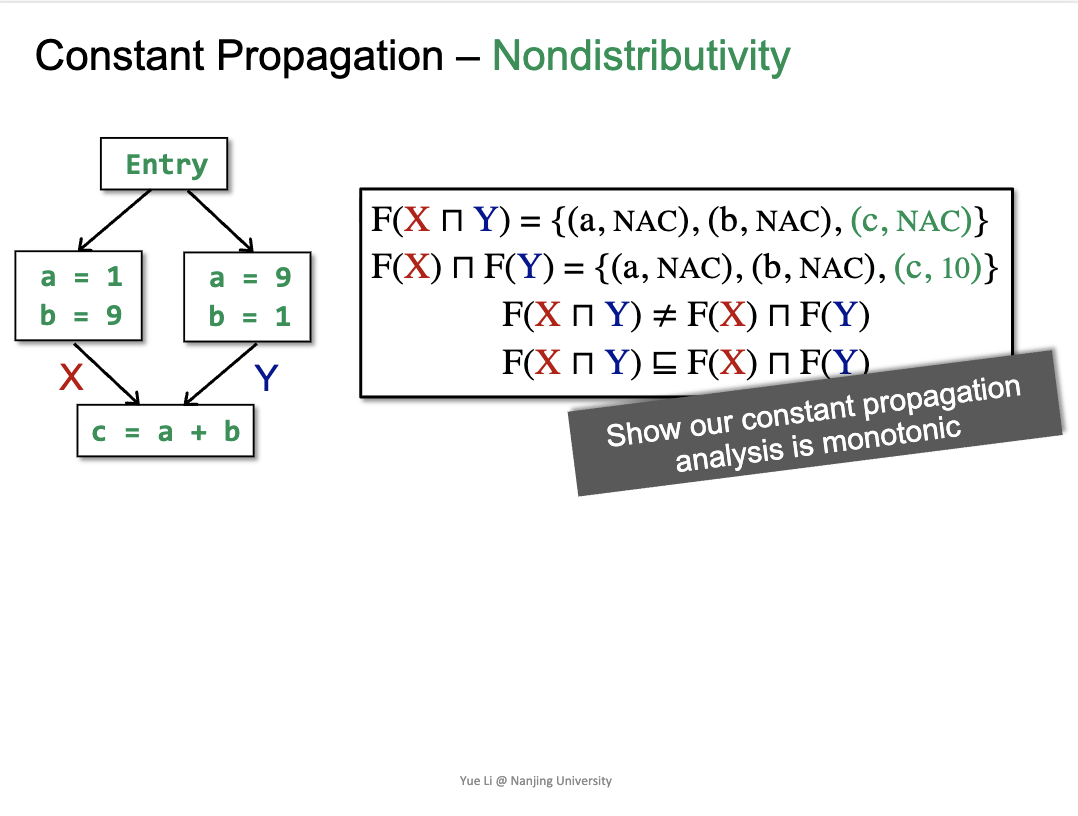
我们的 Constant Propagation 的 transfer function F 是不满足分配律的,所以我们得到的答案并不能跟 MOP 一样好。
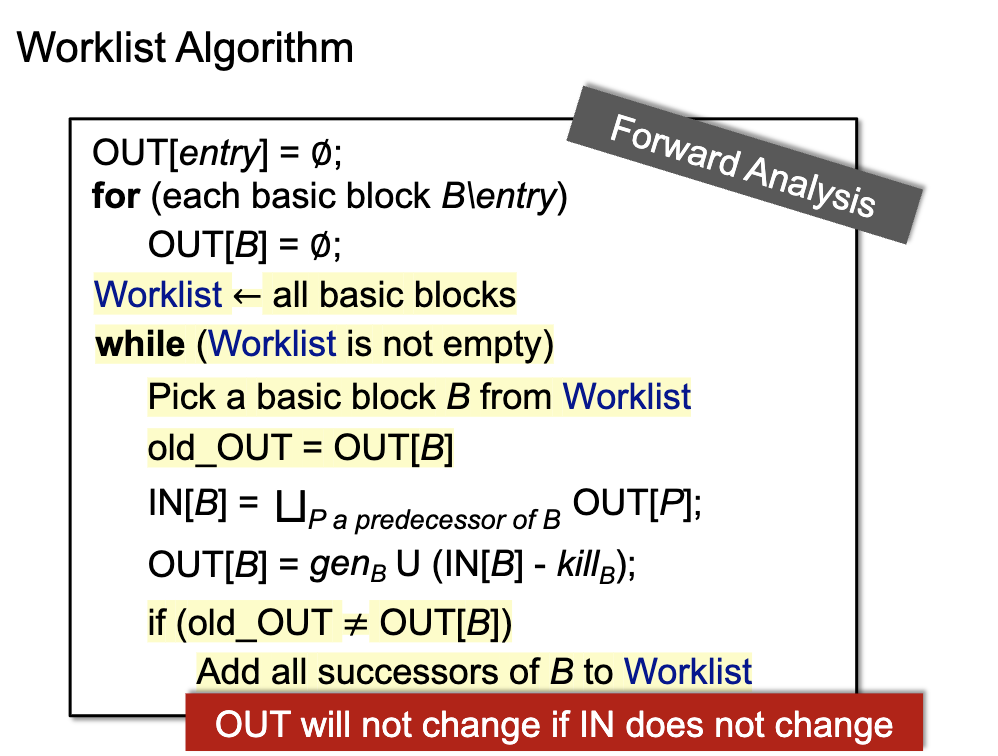
Worklist Algorithm
a optimization of Iterative Algorithm
Iterative Algorithm 是理论上我们使用的算法,它清晰易懂,但是性能却说不上好:因为他每次都会遍历所有路径,但有一些路径在多次迭代过后其实已经收敛了,值不会发生变化,导致产生了重复的计算。
Worklist 算法就是针对这种情况进行了优化,每次只计算需要的路径。