LevelDB 是 google 开源的 LSM Tree 键值数据库引擎,是大概十五年前的工业级实现,从 Bigtable 中抽离而来。在保持精简的实现的同时也支撑了开源世界许多重要的项目,阅读 LevelDB 代码可以在了解工业级的 LSM Tree 实现的同时学习高性能 C++ 编程。
整体架构
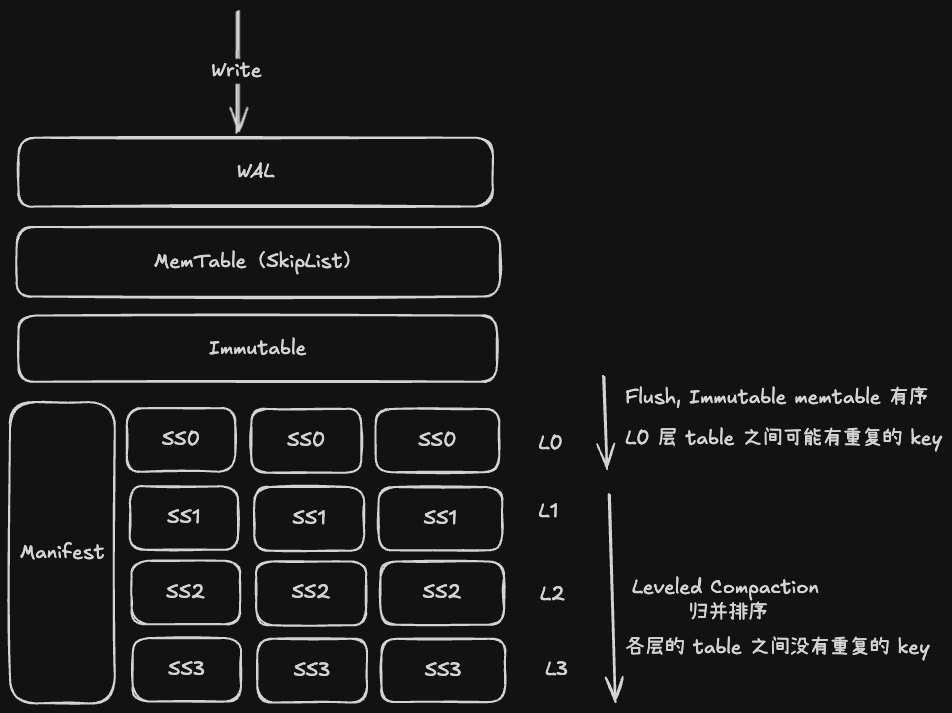
WAL
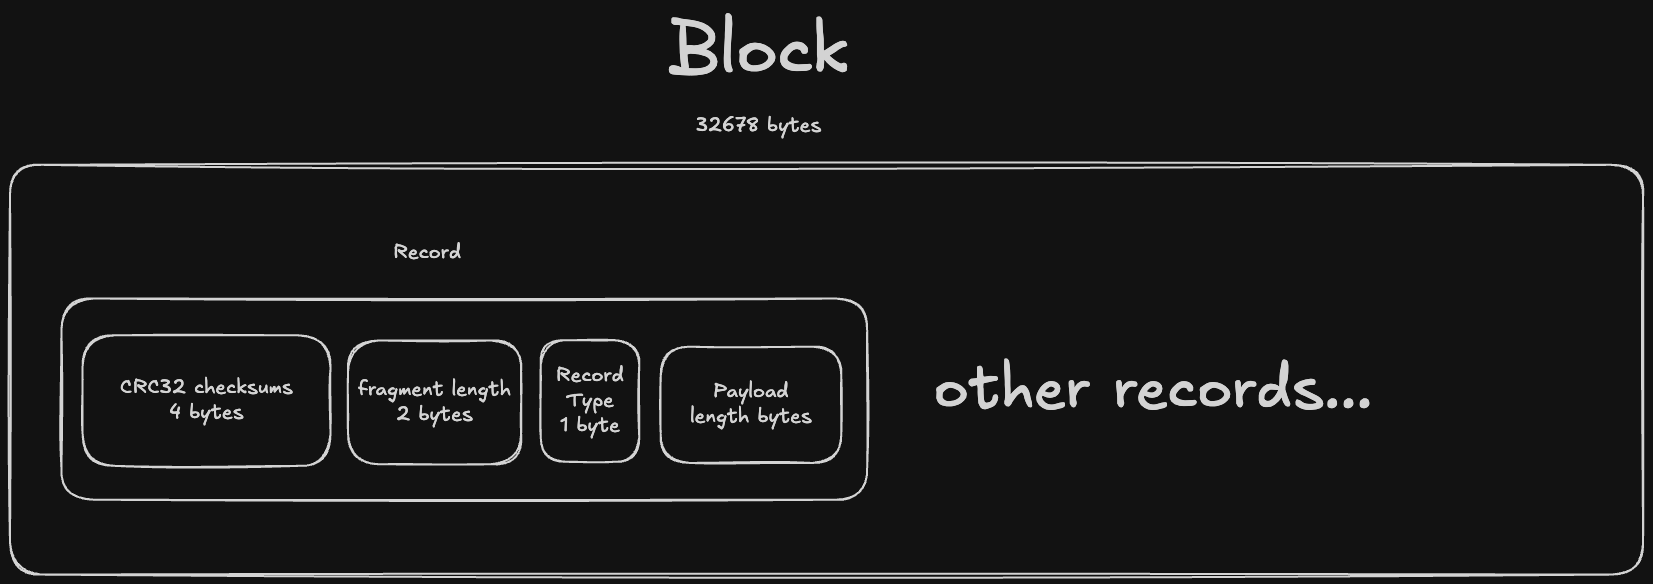
LevelDB 将 WAL 日志的结构编码成了一个字节数组,将他们以 block 的形式写入磁盘。每个 block 的大小固定,里面有若干条 record,每个 record 有一个 7 byte 的 header,7 byte 中前面 4 byte 保存 crc32 教研码,第 5,6 两位保存当前这条 log 在这条 record 中写入的 fragment 大小,第 7 位保存 fragment 类型(全部都在这个 record 里面/这个 fragment 是对应 log 的第一部分/中间部分/最后部分)。
这样就可以跨 block 存储一个大 log 了,并且小 log 占用空间也不会产生间隙,一个 block 里面既可以有很多小 log 的 record,也可以只有一条大 log 的一部分 record。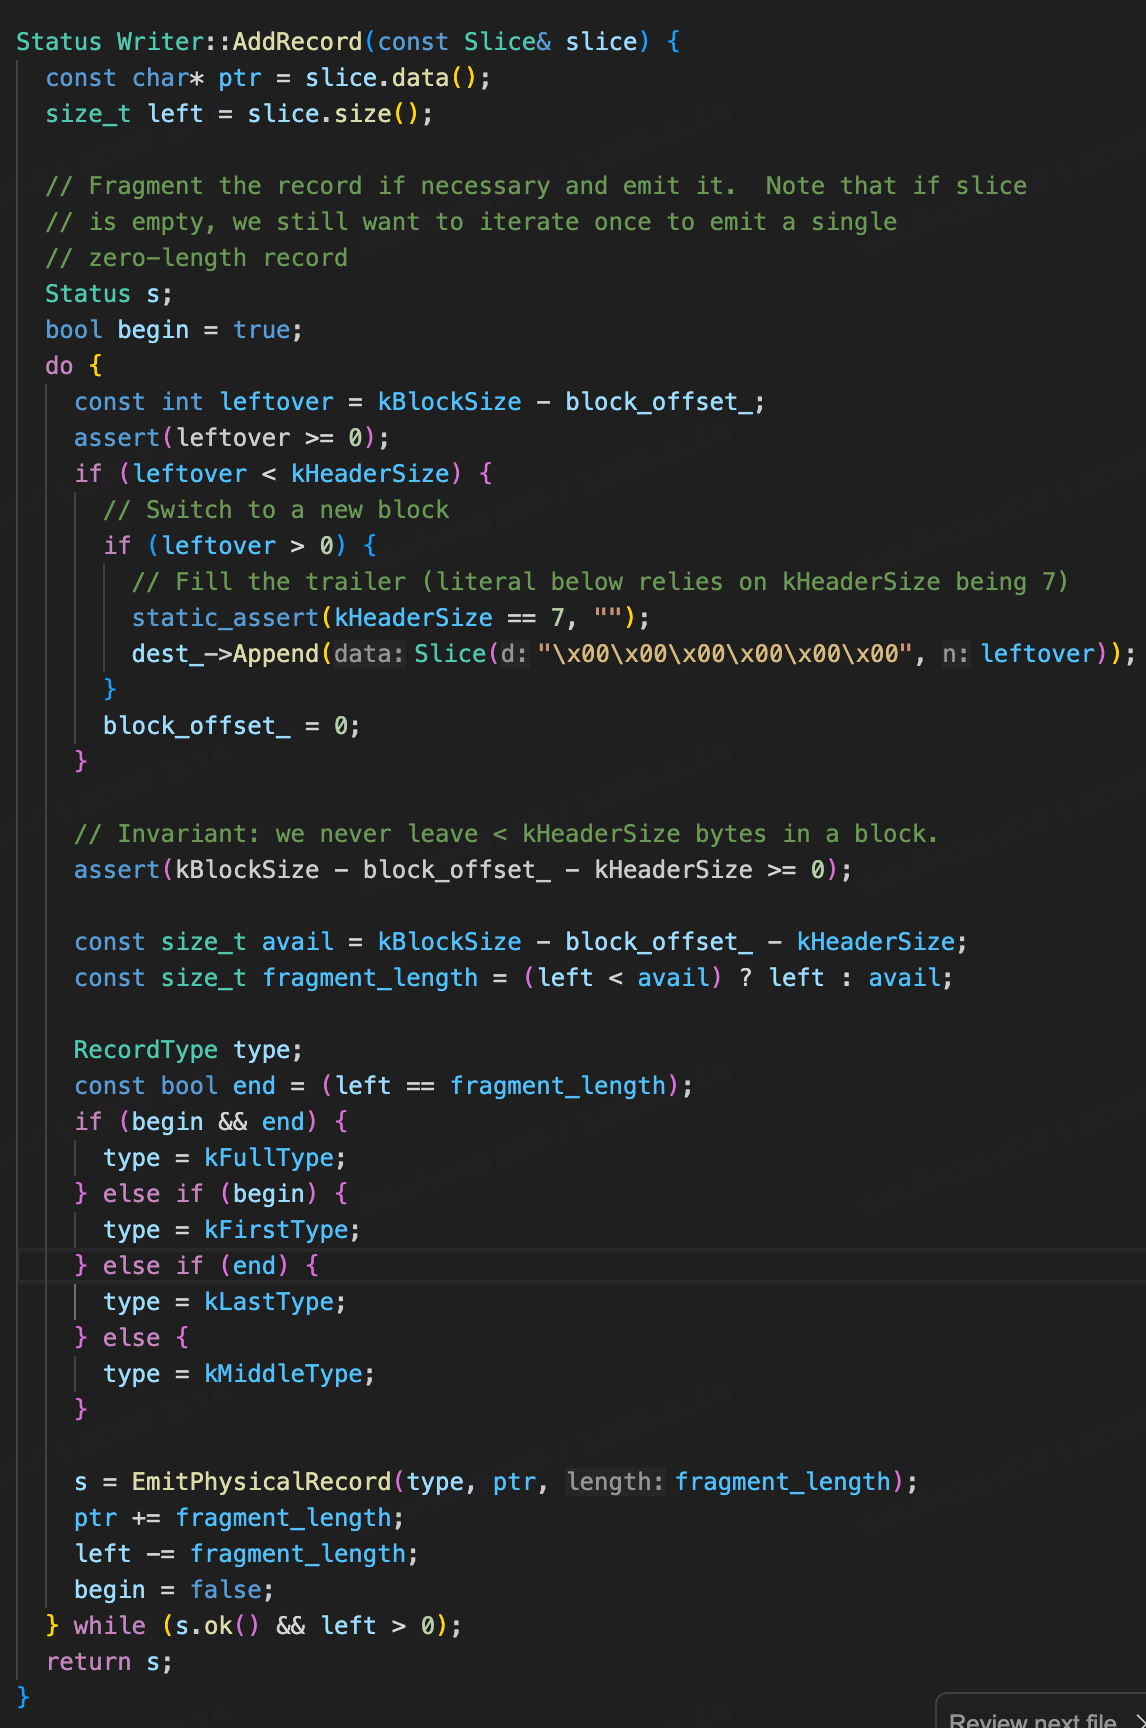
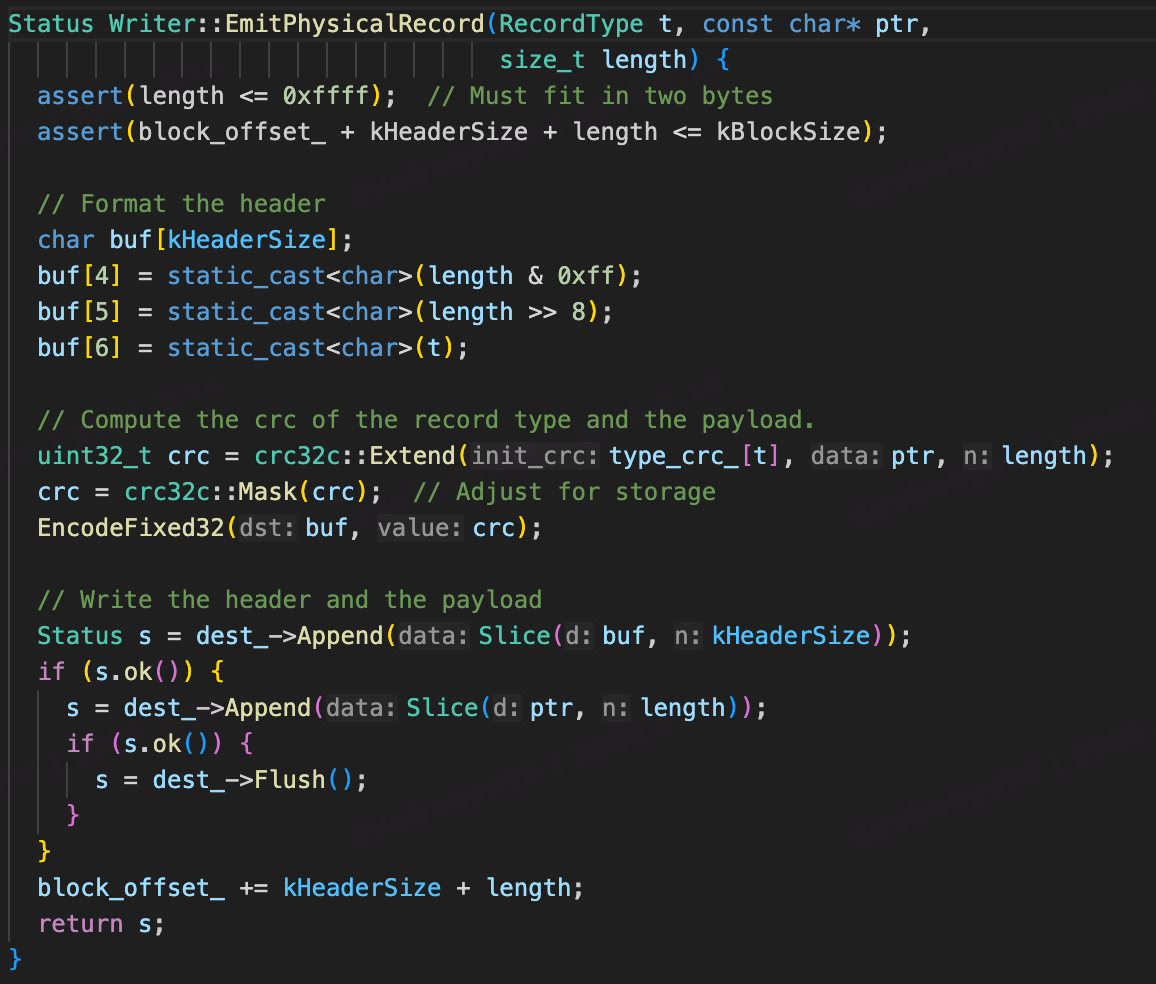
LevelDB 中可以设置是否需要 WAL,如果需要 WAL 的话每次写入都需要等 log 的写入 flush 之后再进行实际的写入,也可以关掉,那么 log 就是普通的日志。
MemTable
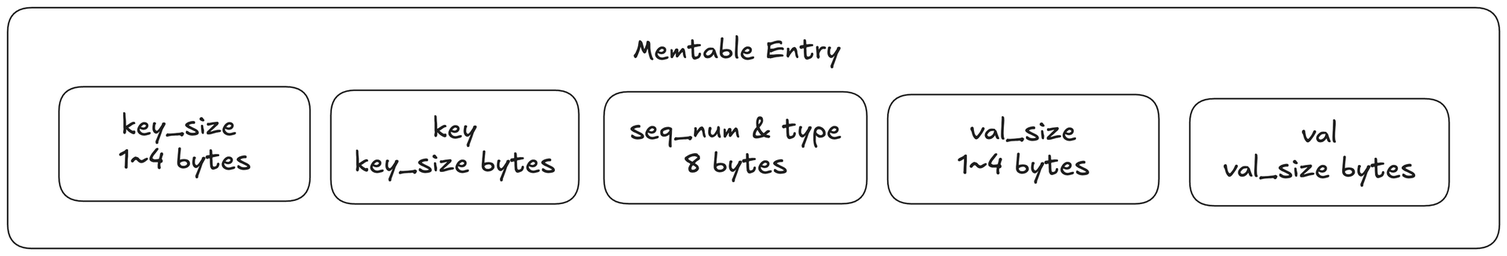
这是单条 Memtable entry 的存储结构,插入时将数据组装成上面的形式然后插入 skipList,MemTable 使用 skipList 意味着:
数据天然有序,后续 flush 到 SS0 无需重新排序
查询时间复杂度降低到 O(logN)
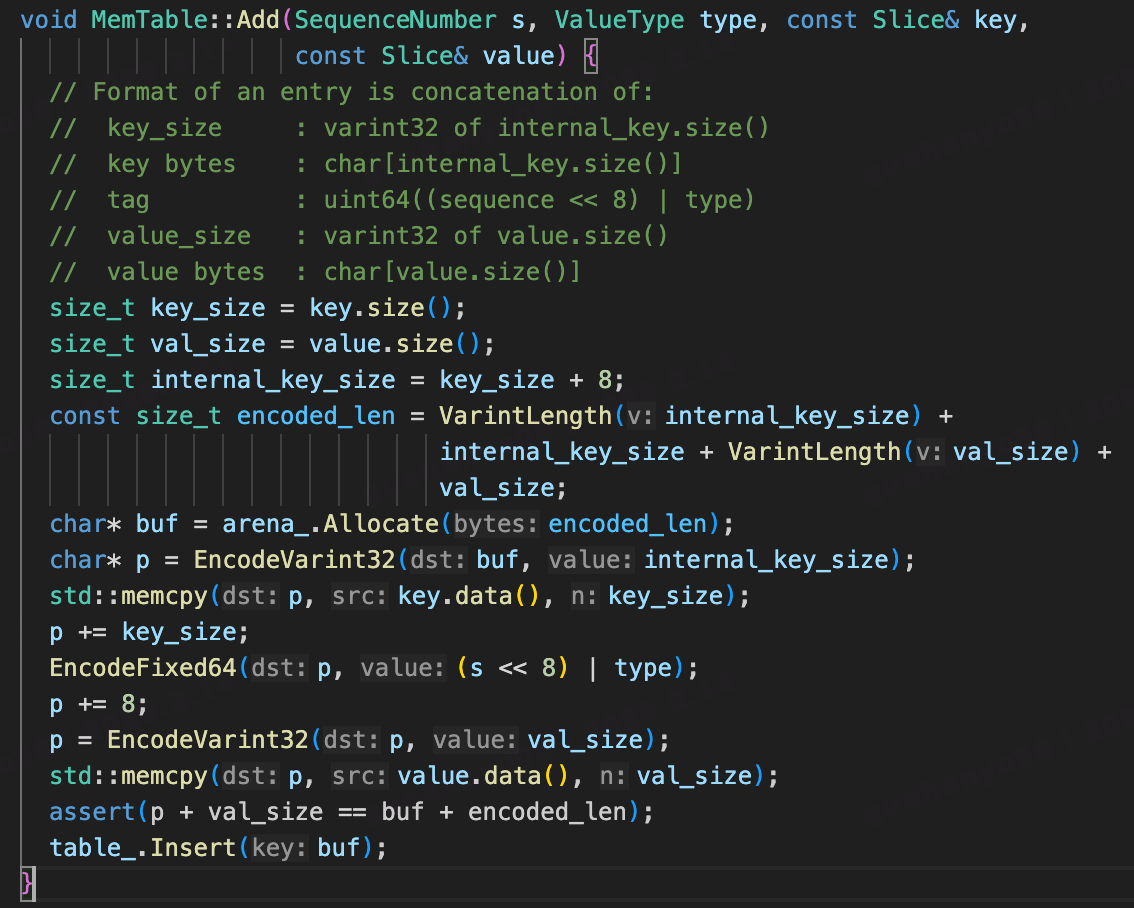
同时,LevelDB 只允许同时存在一个 Memtable 和一个 Immutable Memtable,如果 Memtable 满的情况下,发现 Immutable Memtable 还没有顺利刷写进磁盘,就会阻塞写入。
Manifest
Manifest 是用 append only log 的形式进行组织的,这样设计的好处就是可以提高写入性能,坏处就是读场景需要扫描到最近修改的一条日志。所以为了保证读性能不至于劣化到很差的一个程度,每写到一定大小(2MB)就要将一批 log 合并为一个保存当前全部状态的 snapshot。
且 Manifest 其实也是 WAL,只不过是作用于 metadata 层面的。有一个专门的文件 CURRENT 用来存储当前的 Manifest 文件的路径,恢复时会读取这个文件找到当前的 Manifest 文件,并且通过回放其中的所有 VersionEdit 记录(即单条日志),在内存中重建。
重建后得到的数据结构如下图所示,其中 Version 是纯内存数据结构,是在从磁盘上 recover 到内存后根据某个最大版本号算出来的一个当前状态的快照。
一个有点反直觉的设计是,VersionEdit 其实是没有编号的,顺序按照 append 到文件上的顺序进行编排。
log_number_是从 VersionSet 透传来的,当前 WAL 日志的最低水位,低于这个水位的 WAL 都可以删除了(因为其写入的内容都落到 SSTable 了)。next_file_number_也是从 VersionSet 透传来的,是当前的文件 id 水位,通过 VersionEdit 持久化让下次崩溃恢复时能读到,进而防止新建文件时 id 与老文件冲突。lastsequence 则是 WriteBatch 维度的水位
Recover
先根据 db_name 得到这个 db 的 current file 位置
尝试读取 current file 中保存的当前 manifest 的 指针,找到并读取 manifest 文件(versions->Recover)
读取 manifest 文件其实是一条一条 VersionEdit 日志的形式读的,一条一条 apply 就可以把当前最新的状态(next_file, log_number, last_sequence)给算出来
根据读出的 VersionEdit 动态计算出最新的 Version
从 version 中读出所有文件名,根据文件名筛选出其中的全部 log 文件,并将它们按编号排序
按顺序 recover 日志文件,其实就是把里面的日志一条一条读出来,把内容插入 memtable。如果 memtable 太大(这个大小是 approximate 的)则会将 memtable 落盘到 SS0 并开一个新的 memtable,最后的 memtable 也会被写进 SS0,也就是说 memtable 之前丢失的内容恢复后都会被直接刷写进 SS0。
Compaction
在 VersionSet::PickCompaction 可以看到,当前的 version 如果 compaction score >= 1 则会触发 size compaction,如果当前 file_to_compact 不为空则会触发 seek compaction。
在 leveldb 中,每次 compaction 只会选择一个文件,如果 compact 完发现不够才会再选择下一个。
size compaction 会尝试从 compaction 的对应层级中选一个文件进行 compact,同时 compact 完会记住上次 compact 的文件位置,当层下一次 compact 会从下一个文件开始选起,实现了一套轮换 compact 机制。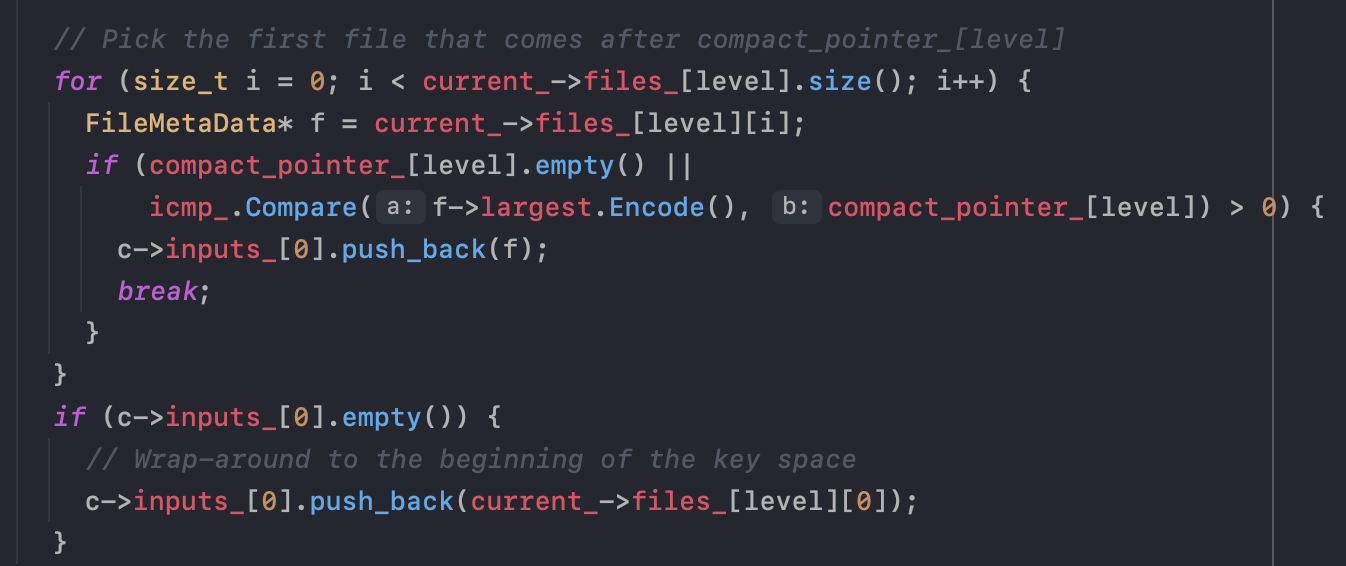
而 seek compaction 的触发则说明对应文件的查询命中率太低,应该被合并到下一层,压缩的文件自然选择这个命中率低的文件。
如果 compact 的目标是 L0 的文件,则需要考虑 range 跟其他同层的文件重叠的情况:需要把所有跟他有重叠 range 的 L0 文件全部选进来。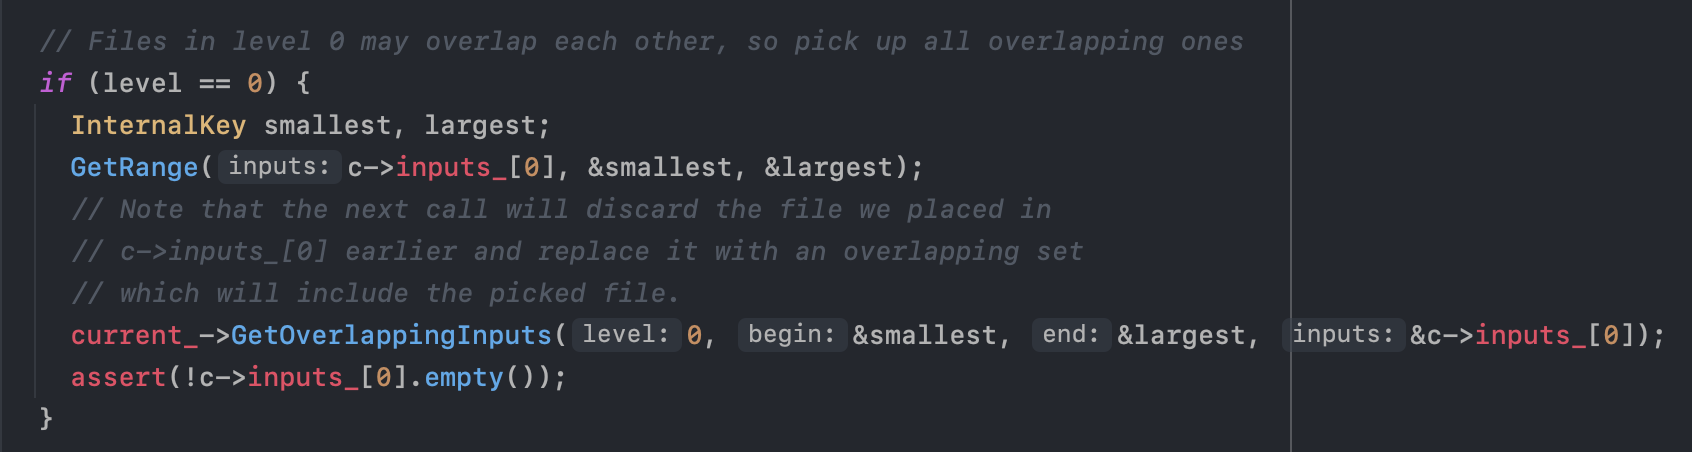
然后就是从 N + 1 层找跟文件 range 匹配的文件了,它们也将作为本次 merge 的输入。这里需要考虑一个 MVCC 的边界条件:如果有多个 key 相同但 seq 不同的值分别在两个不同的文件的边界,这样他们的范围可能没有交集,但仍然需要把他们都选择上。
并且会尝试扩大 Level N 的输入,用 Level N 和 Level N+1 已经选中的文件的总范围来反查 Level N 层还有没有文件可以一起 compact。这是一个性能优化的点,可以减少总 compaction 操作次数。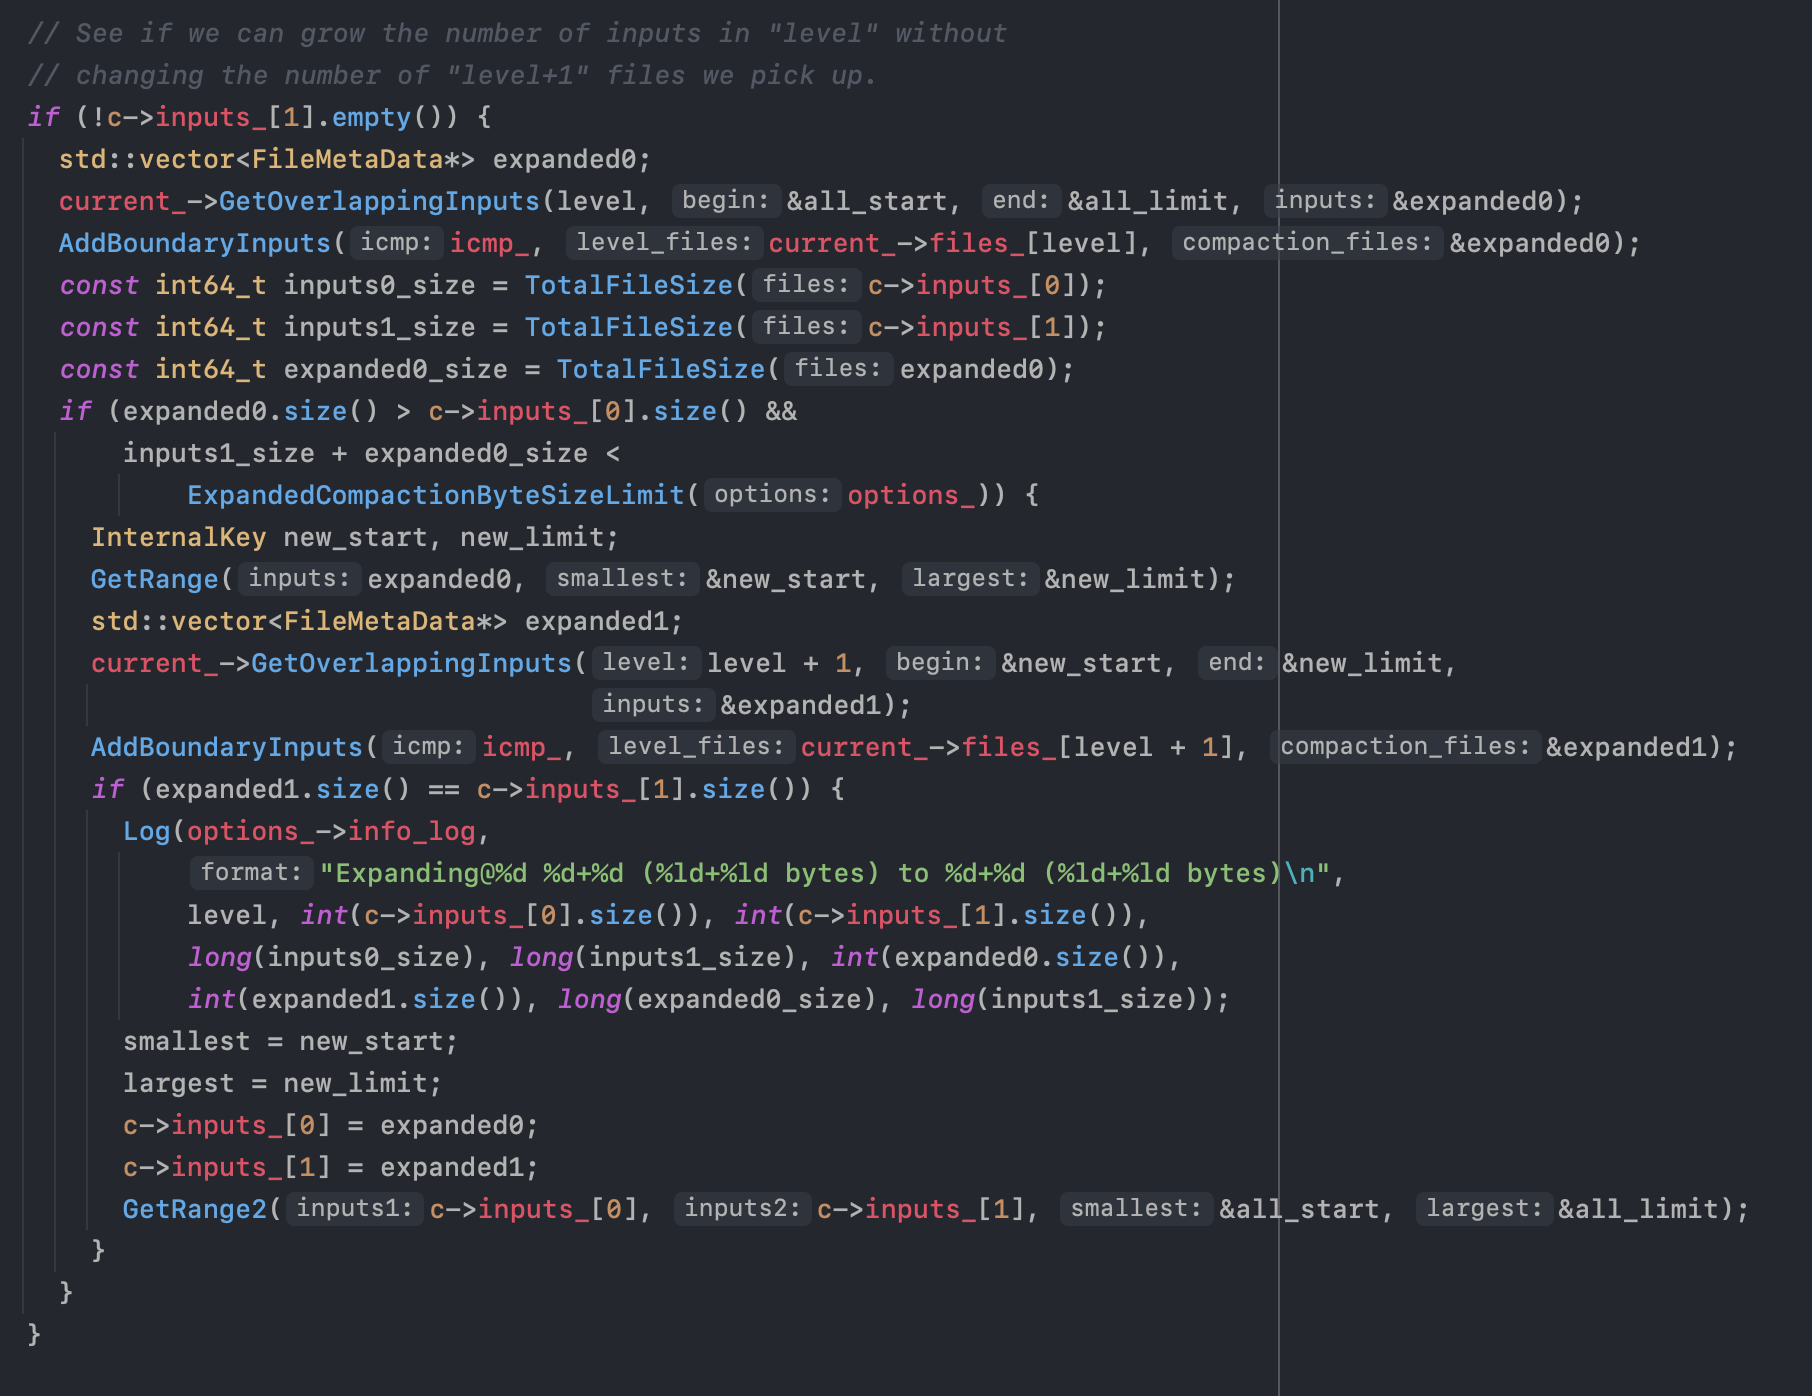
并且这里还有一个 grandparent 的性能优化:会尝试将 Level N+2 中与本次 compaction range 重合的部分记录下来,以供 DoCompactionWork 里判断什么时候切换输出文件(防止输出的文件与 grandparent 重叠太多,导致下一次 compact 代价过大)。
到这里我们便得到了一个 compaction 任务,包含具体需要合并哪些文件,但具体要输出到哪些文件?新建一个文件全写里面?还是拆成几个文件?怎么拆?这是接下来要解决的问题。
在 N+1 层没有任何输入文件,即 N 中选择的文件的范围跟 N+1 层中的任何文件都没有重叠,这种情况下可以有一个性能优化:只需要把文件移动到 Level N+1 即可,不需要走后面的合并排序步骤。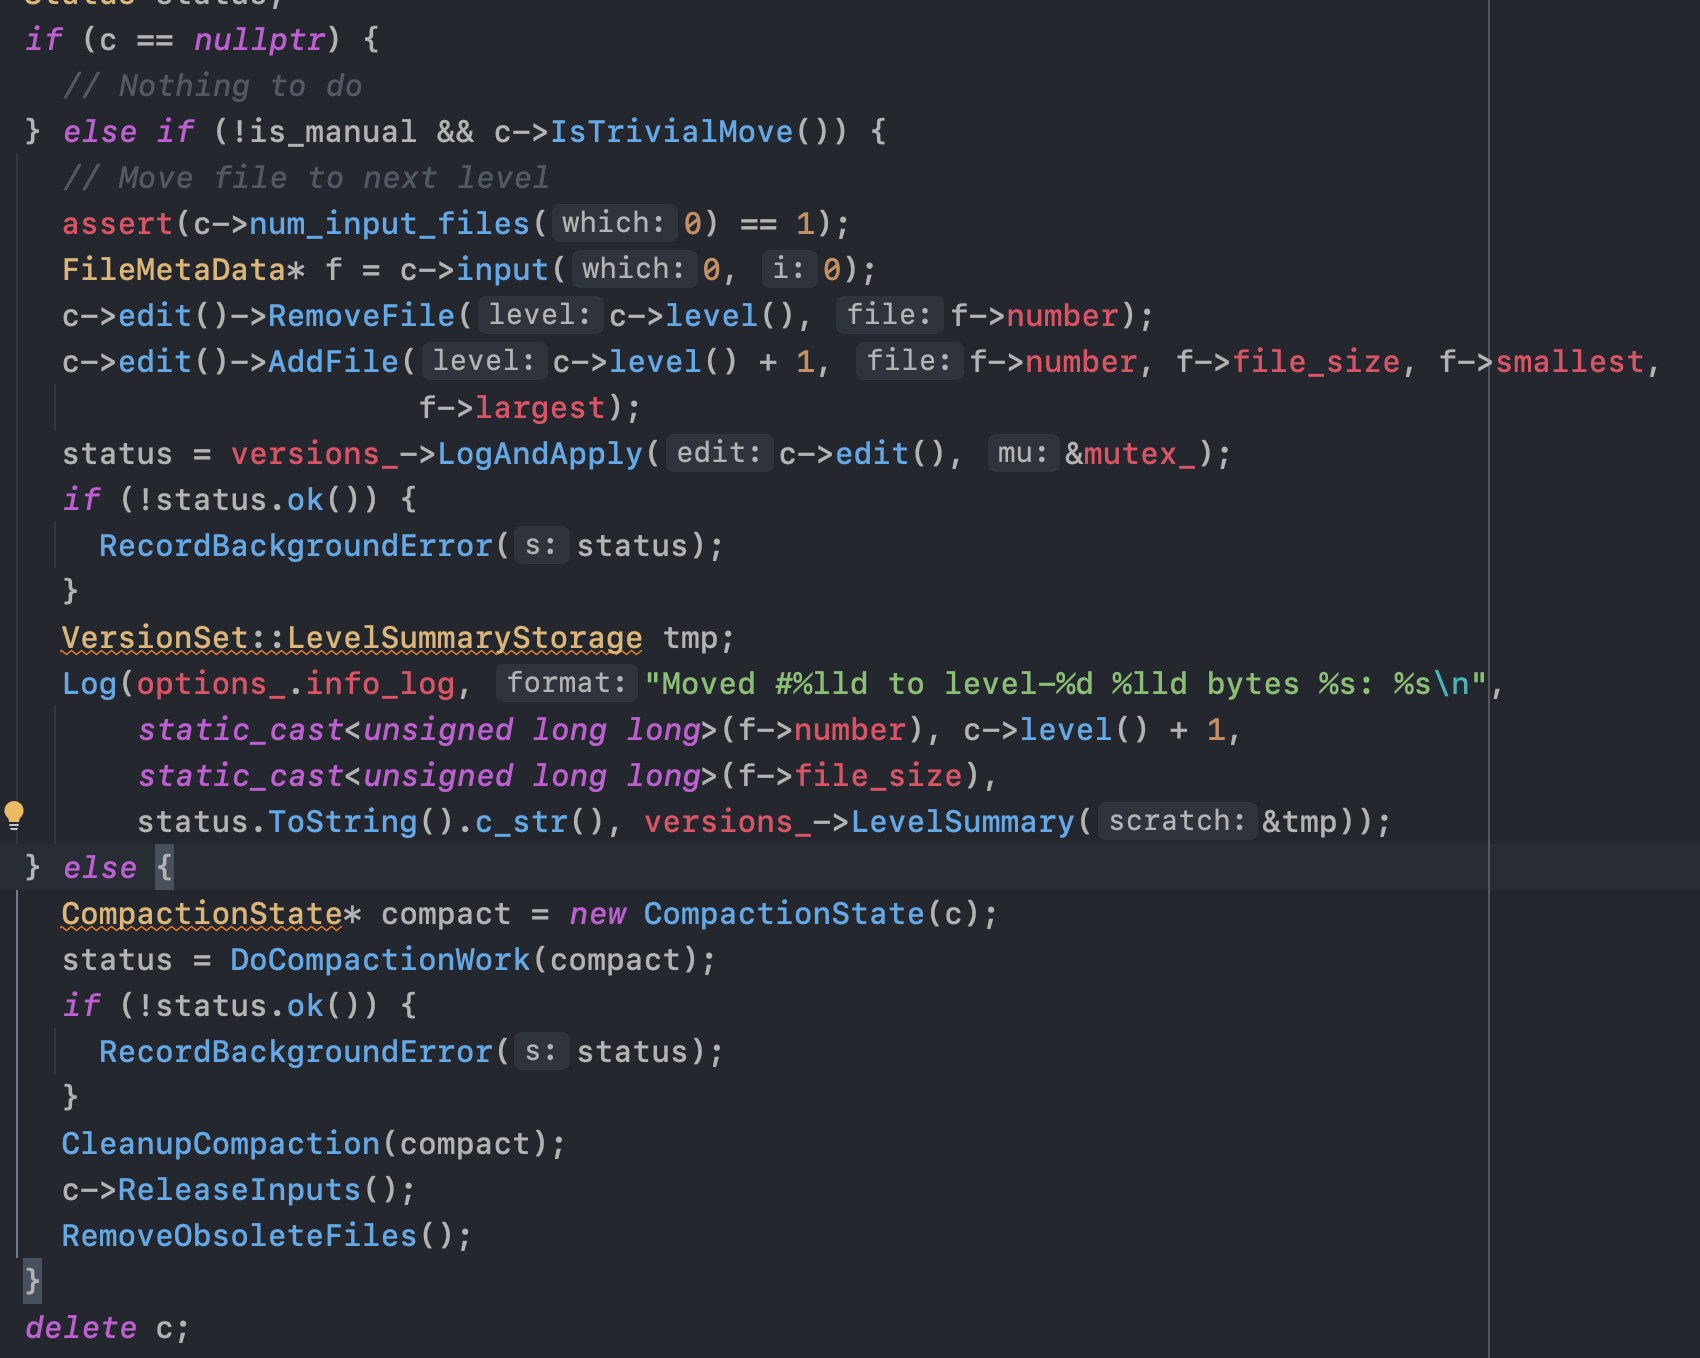
接下来就是实际的 compact 操作了,将选择的所有文件的 kv 都弄一个 iterator,这些 iterator 输出的值是有序的,再把它们组合到一个 MergeIterator,就将它们合并成一个有序的 kv list 了。
压缩的过程中,重复出现的 key 如果 sequence 比前面的 key 小,则会被丢弃。并且如果当前最大的 key 对应的是一个 deletion marker,且更低的 level 没有这个 key 的旧数据,也可以丢弃。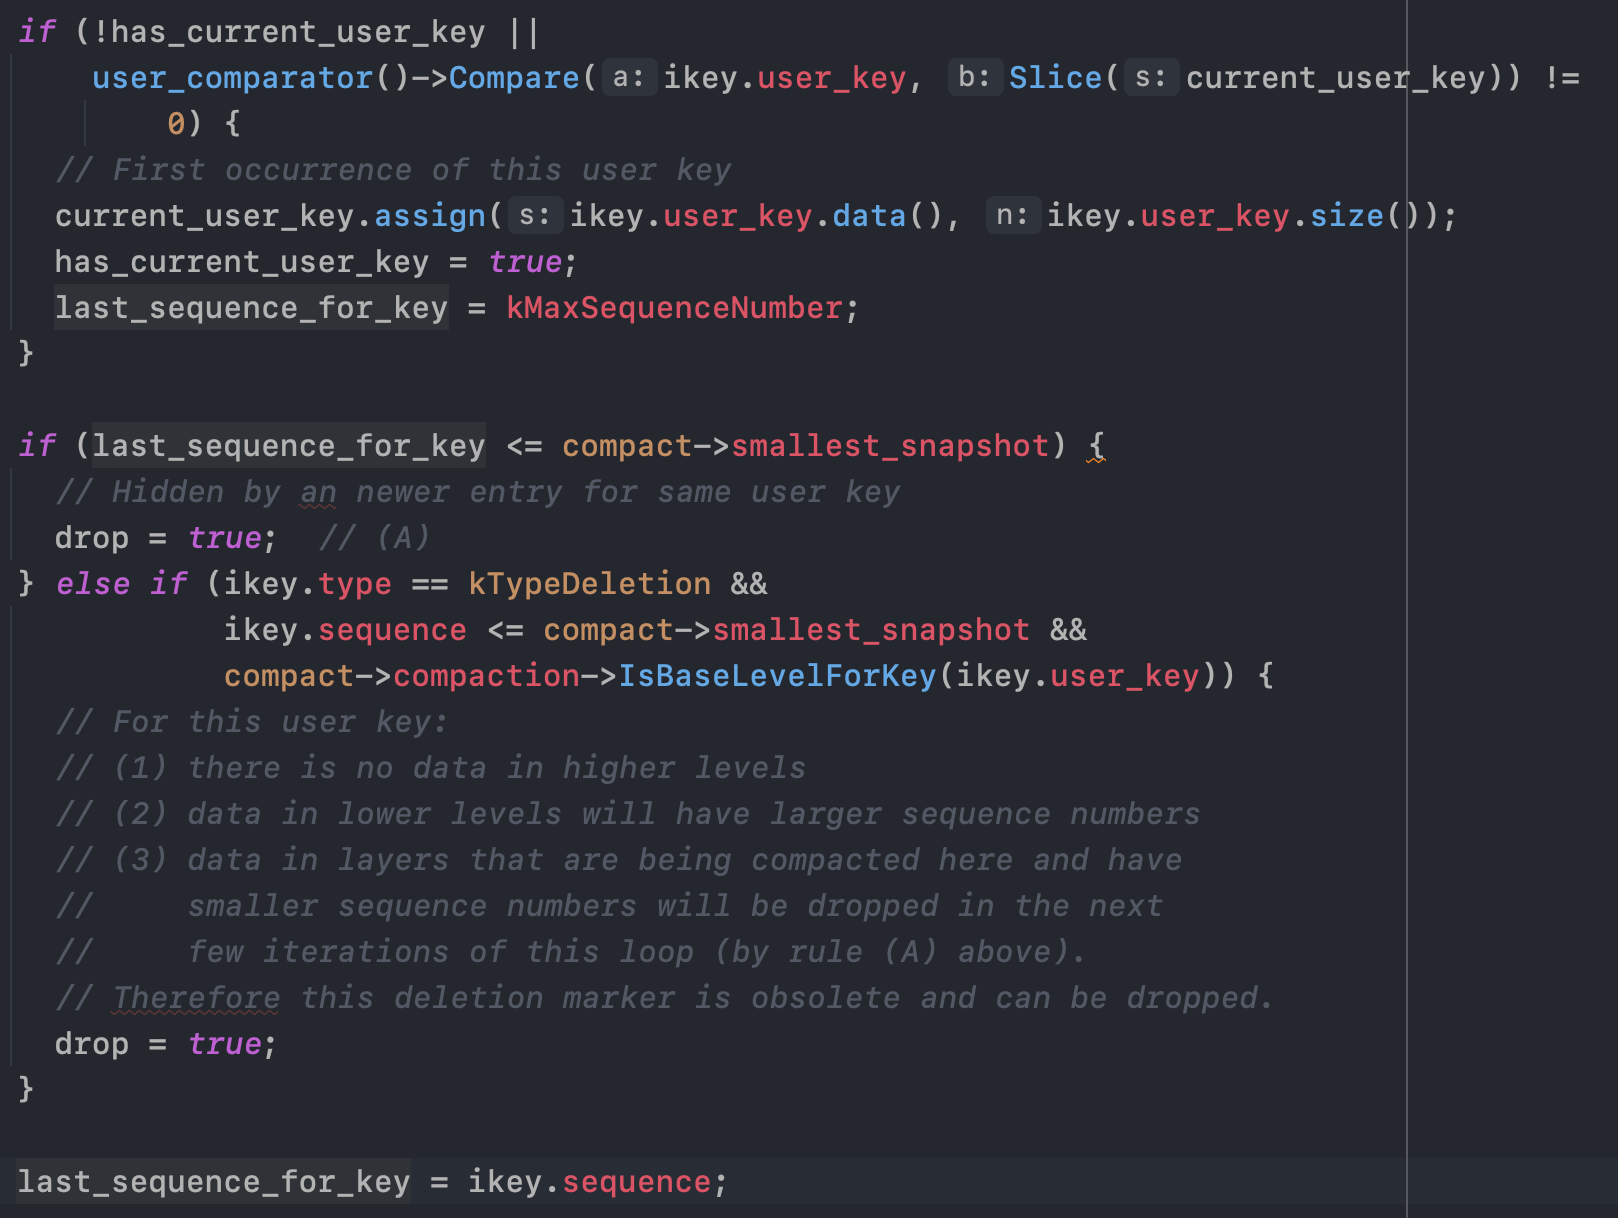
如果 compaction 过程中新的 imm_ 出现了,就说明当前写入压力大,优先将 imm flush 到 Level 0,这也是一个优化点。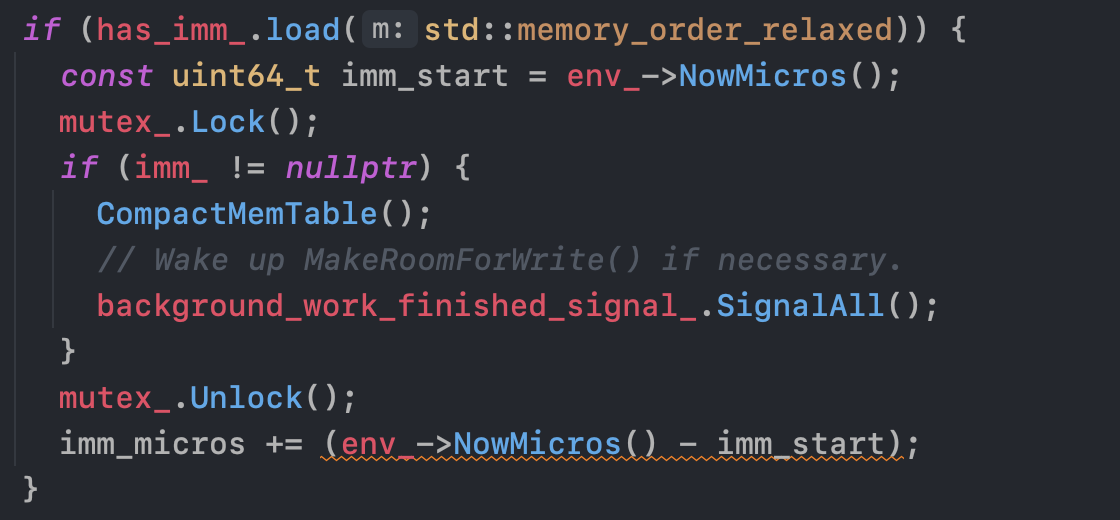
如果当前 key 不需要 drop,则将 kv 写入新文件,每个文件按照固定的大小进行分割。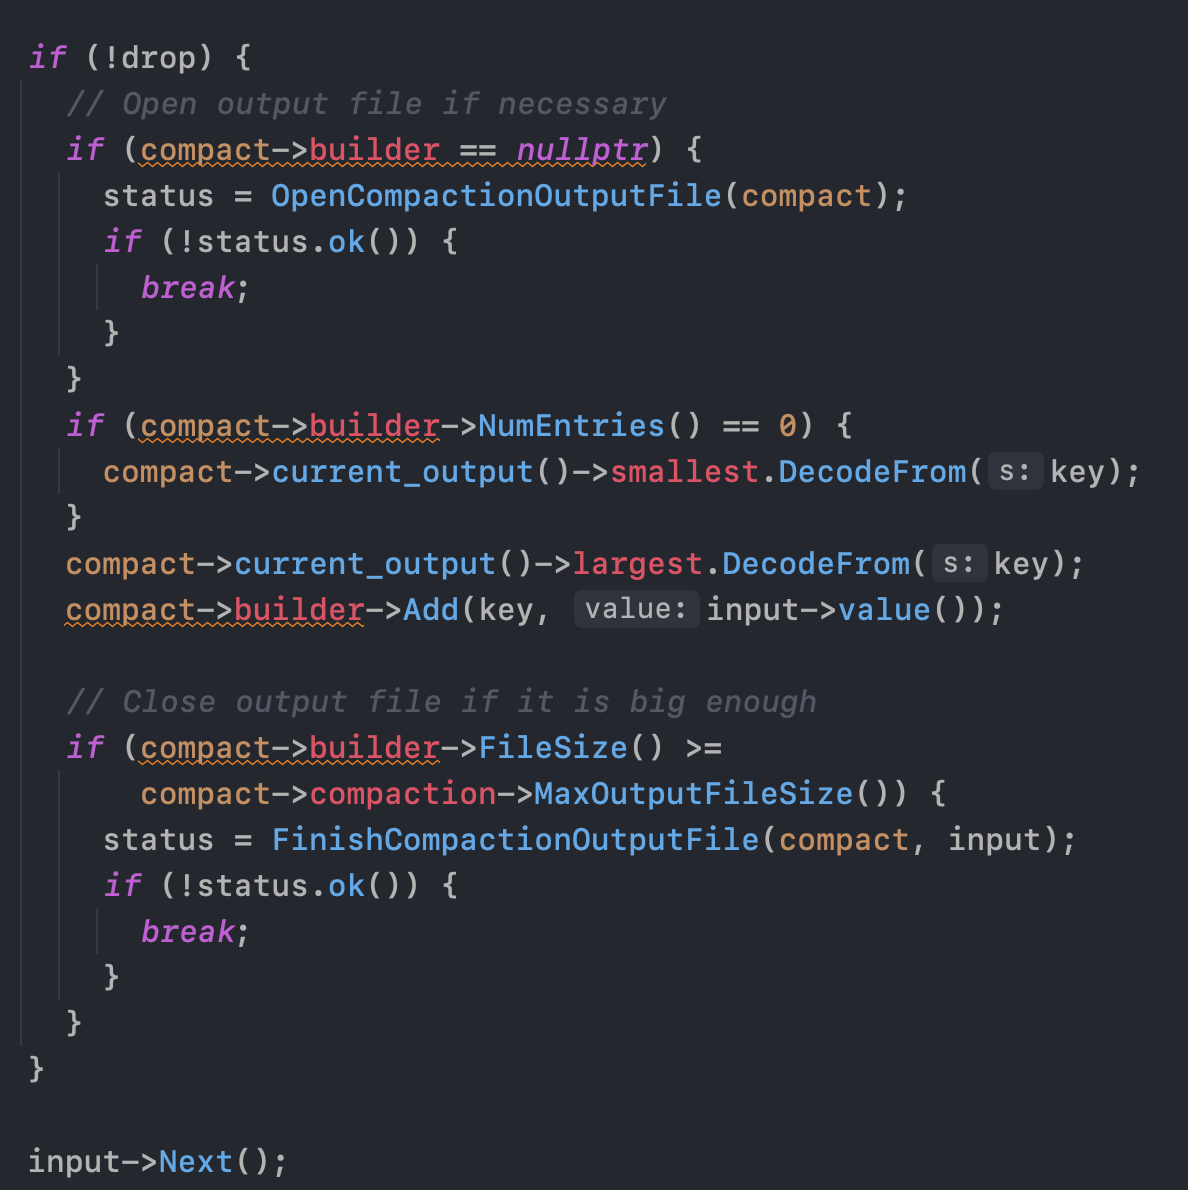
这一系列操作完成后再 apply 变更到 manifest。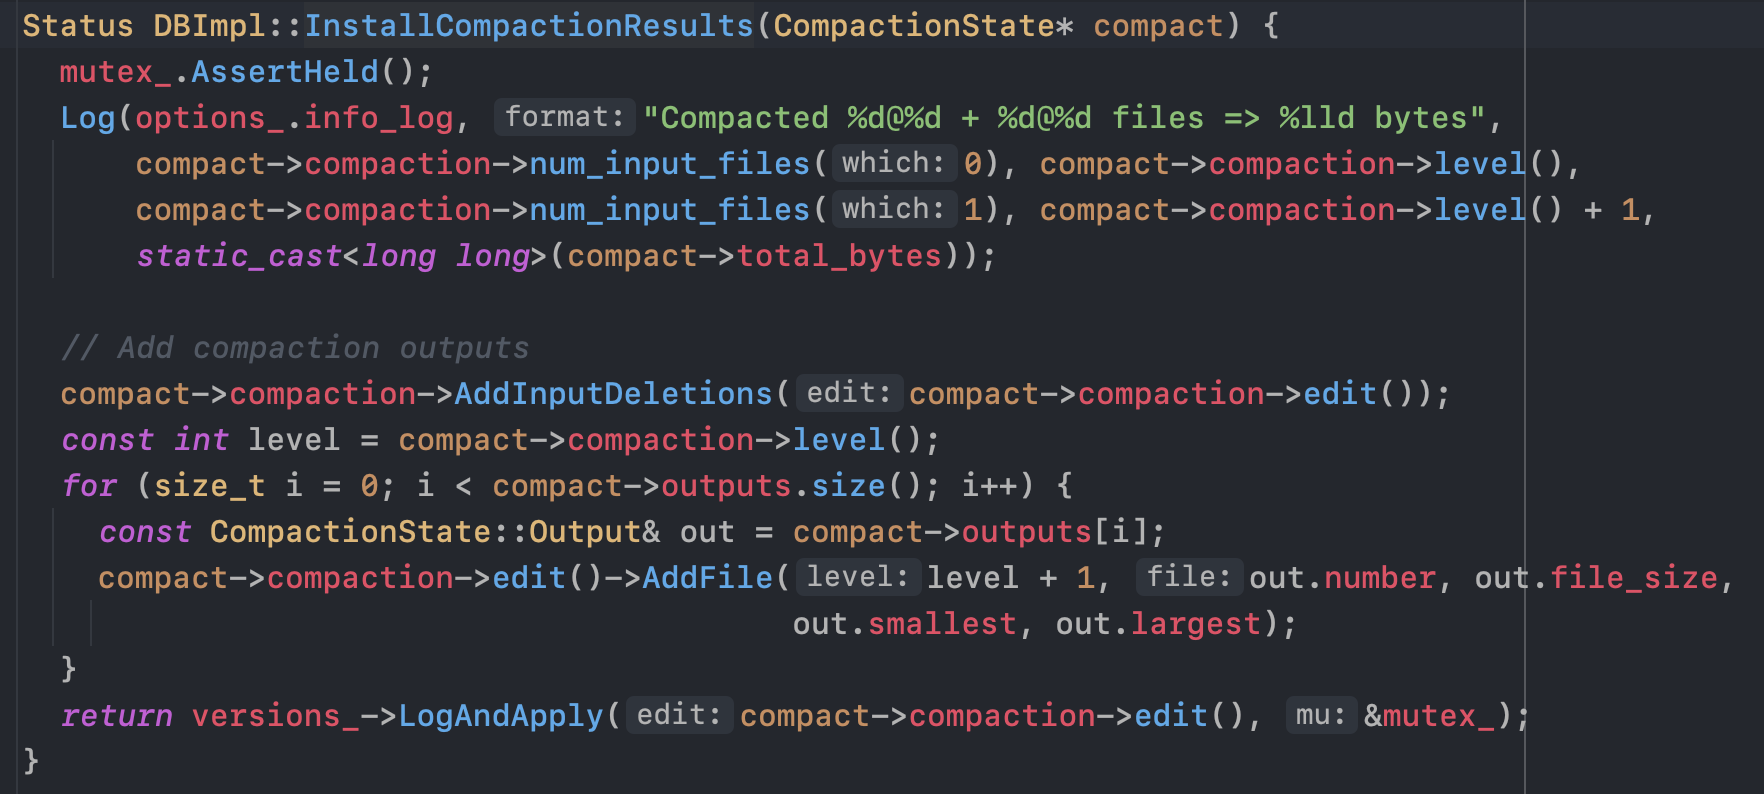
Read Path
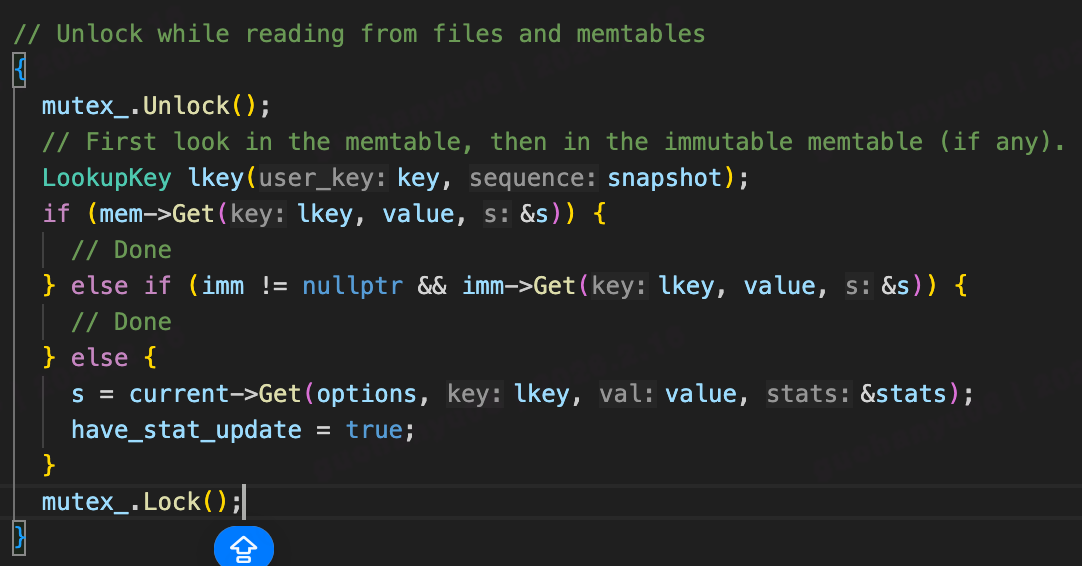
先从 memtable 找
memtable 找不到从 immutable memtable 找
immutable memtable 找不到就尝试从 current version (SSTable)找
memtable 查找就是 skipList 的查找,重点还是在 SSTable 的查找上L0 文件的范围可能有重叠,则从最新的文件开始从新到旧扫描,以扫描到的第一个为准
如果 L0 没有,则在其他层级依次二分选择文件。
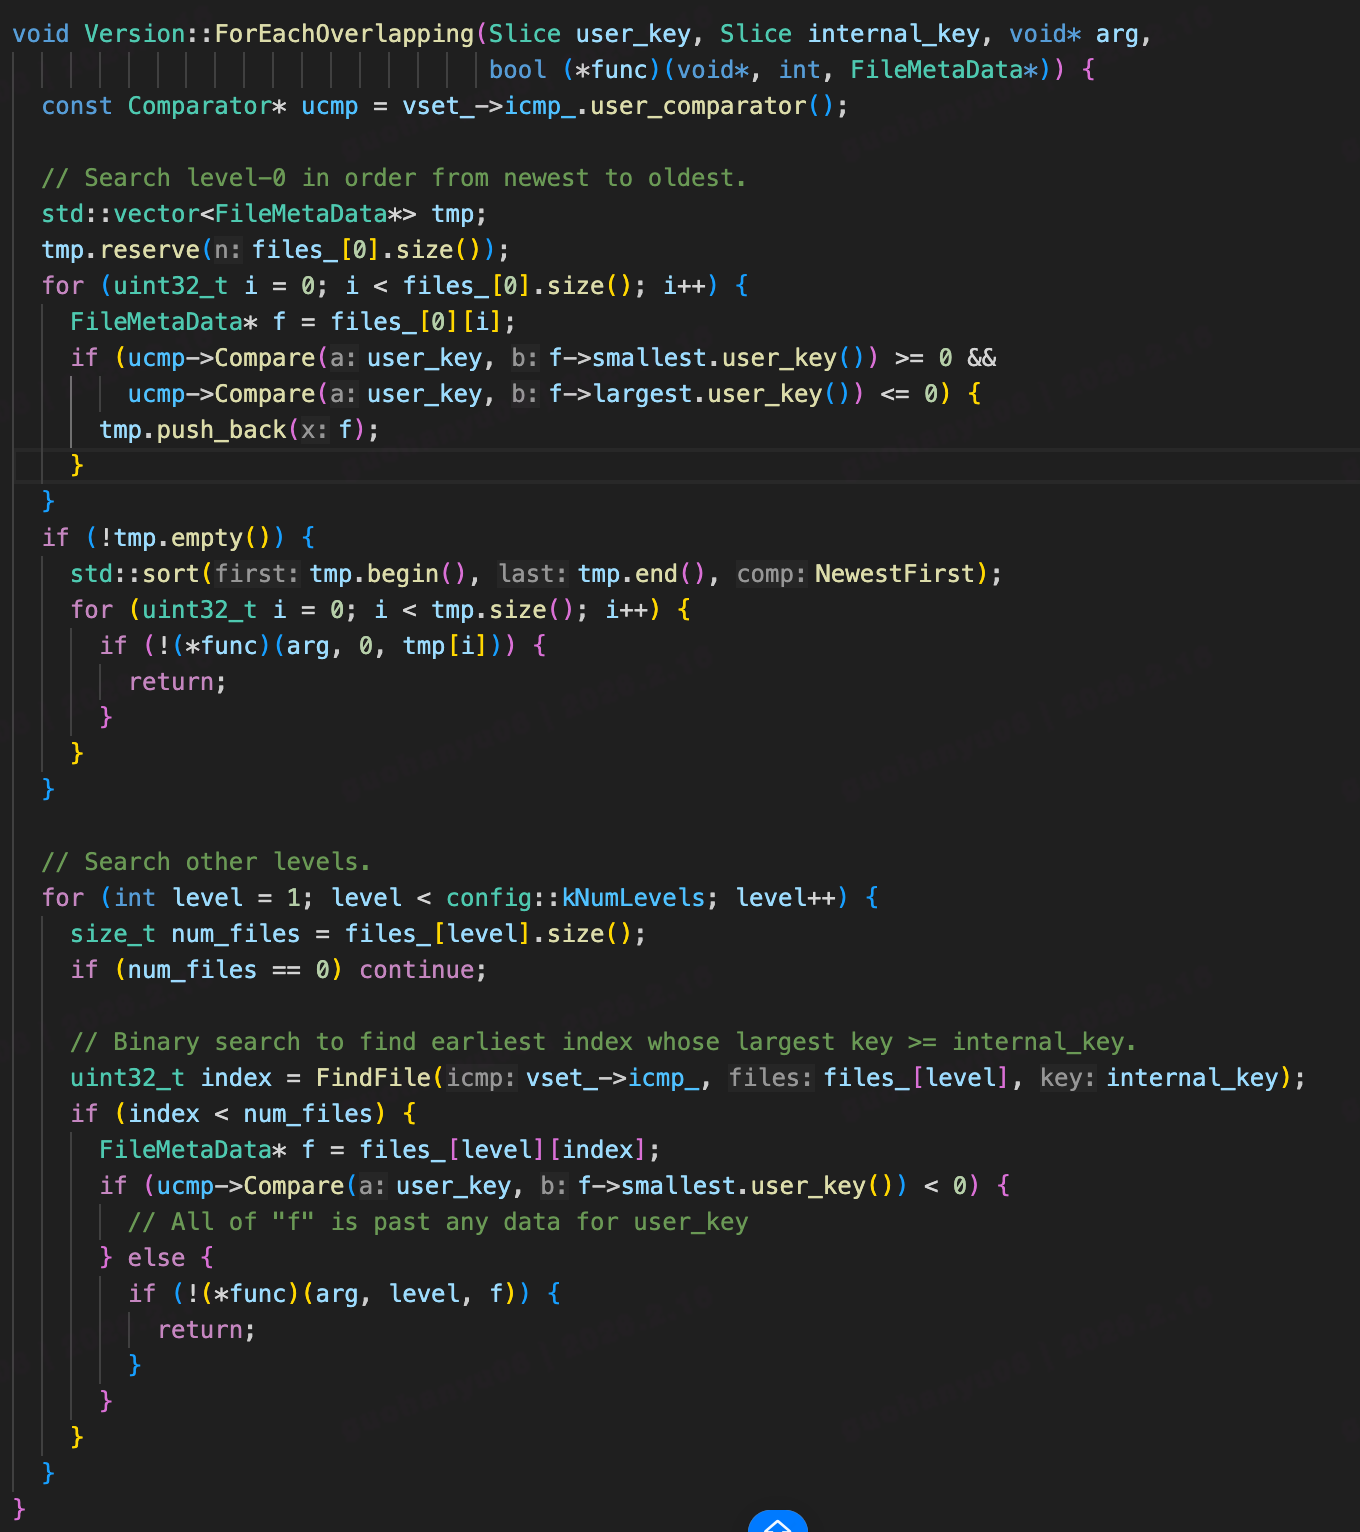
搜索会先尝试在 TableCache 中查找,leveldb 最多会在内存中缓存 990 个 SSTable 的数据。如果缓存中没有的话则会懒加载到缓存中(只加载文件句柄和 metadata)。
然后先读 index block,尝试在索引中定位到可能包含 key 的 block,再通过 bloom filter filter 一下,如果有可能存在再读出这个 block 进行二分查找(data block 做了前缀压缩,所以只能以16个为一组进行二分,然后再在这16个里面进行线性查找)。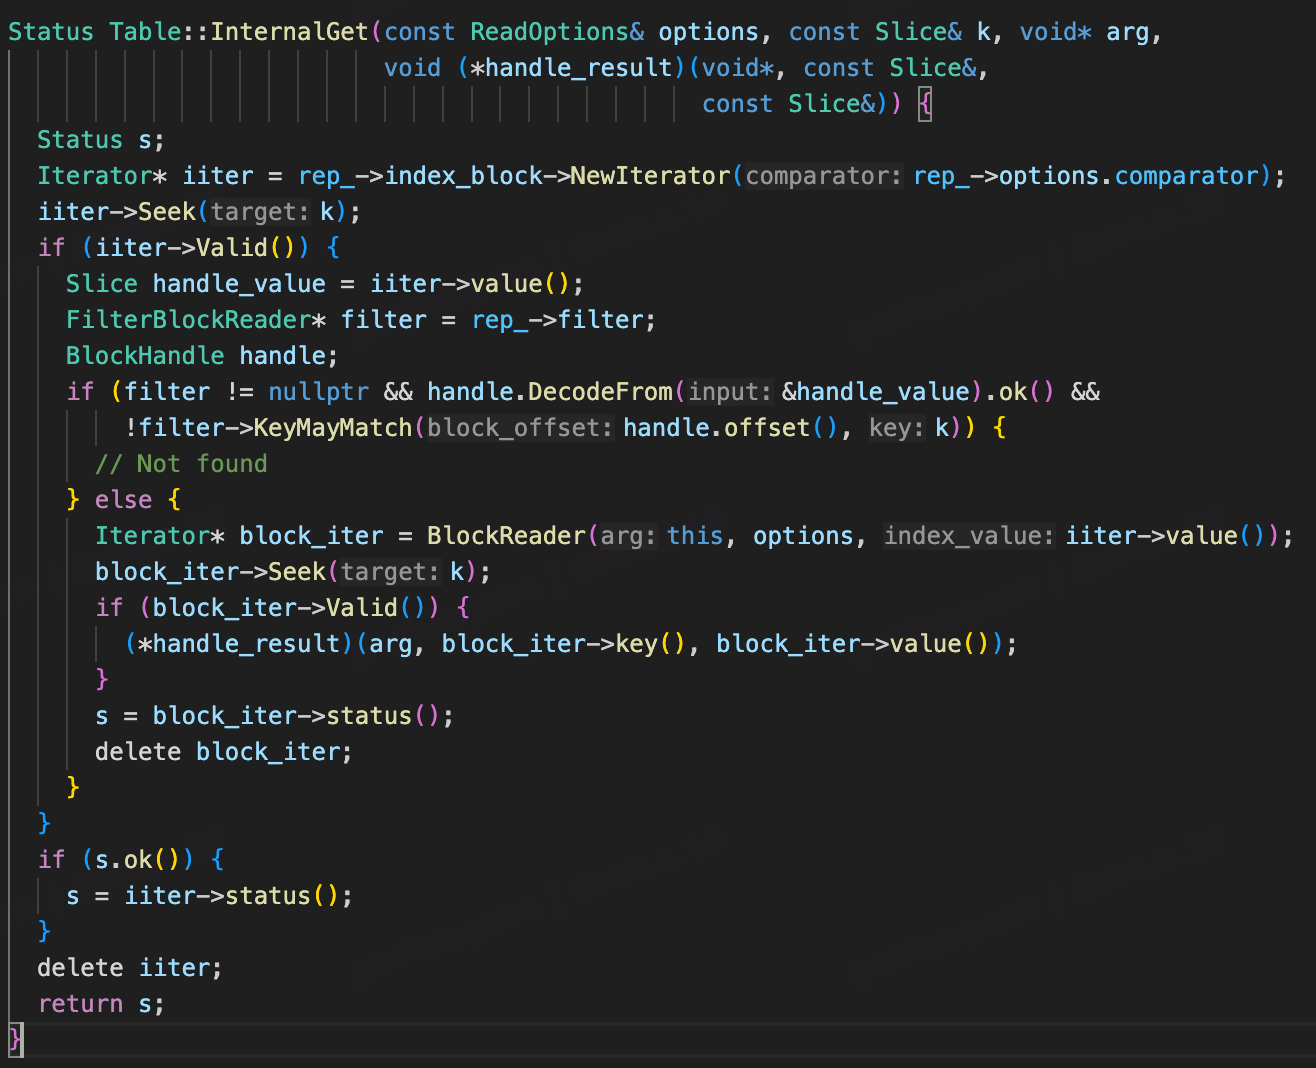
奇技淫巧
Leveldb 的架构现在来看就是很普通的 LSM-Tree 键值存储引擎的架构,跟我做过的 mini-lsm 教学项目其实差不多。
那是什么使得 Leveldb 可以成为一个工业级实现呢?魔鬼都在细节中
SkipList
LevelDB 的 memtable 使用了 SkipList 来作为保存 key-value pair 的数据结构,这使得在 memtable 中扫描的时间复杂度变为 Olog(N)。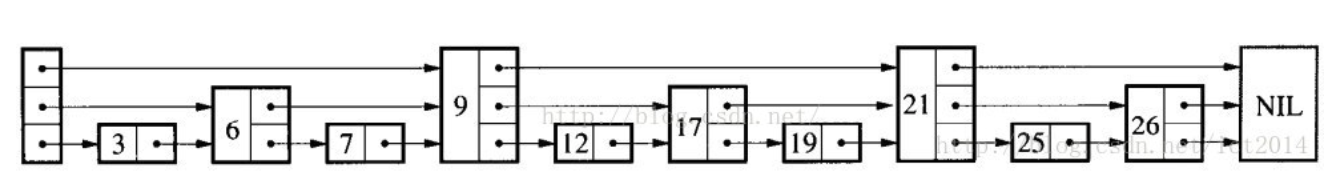
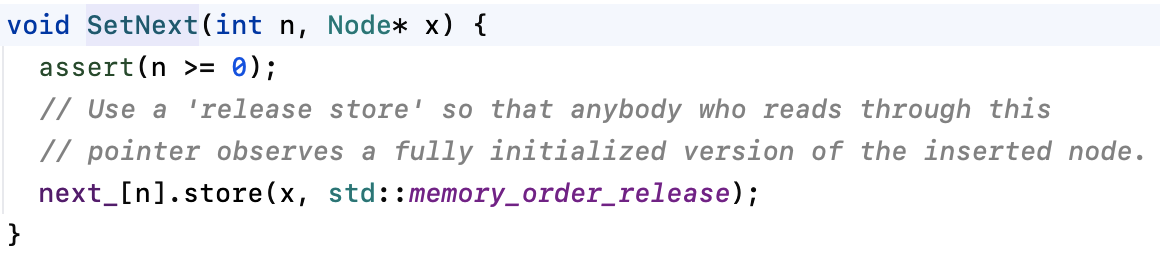
值得一提的是,由于是基于指针操作的数据结构,所以很适合做成无锁。SkipList 的读操作都不需要锁,而插入操作则使用了 atomic 进行原子操作实现无锁。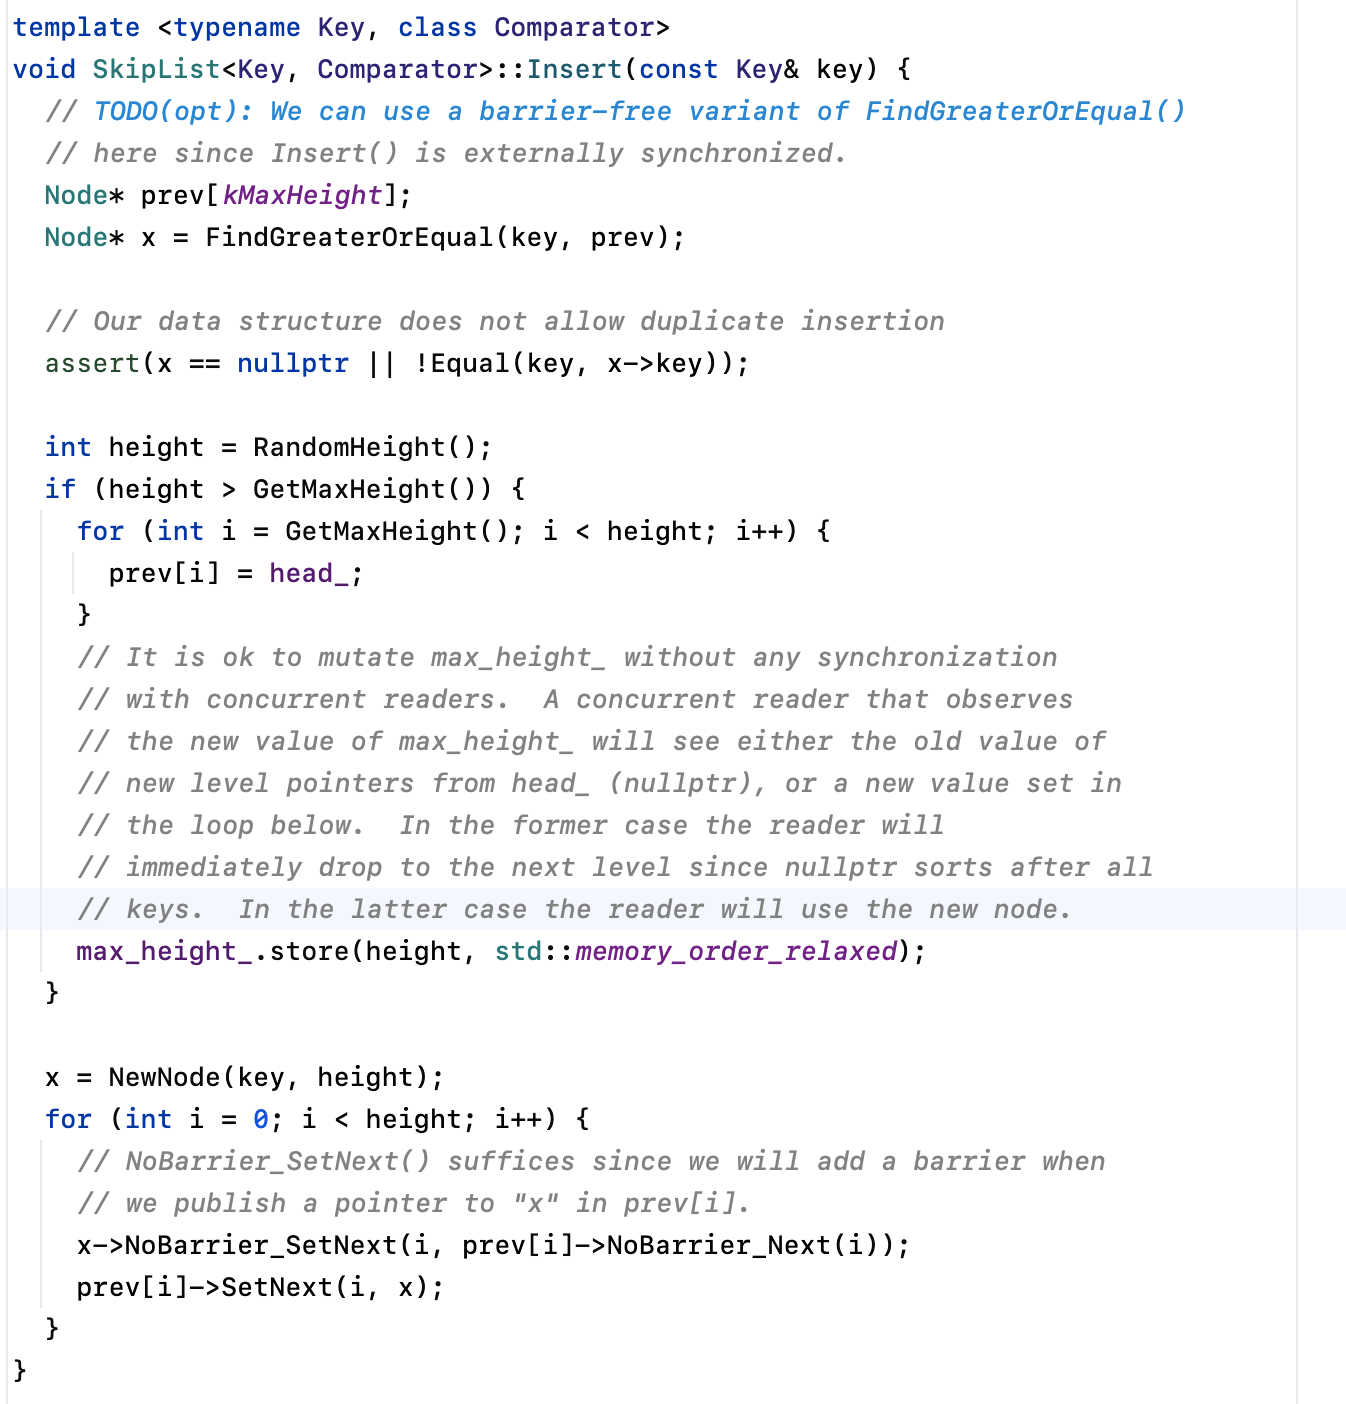
Arena
Arena 是一个内存池实现,他的目标是减少 malloc/new 调用带来的系统调用开销。libc 中对 malloc 的实现比较通用,而 Arena 是在其之上的针对大量小对象的特化实现。这样只需要通过 malloc 申请几个大的块,就可以管理大量的小对象。
需要注意的是 Arena 通过不提供 free 接口来简化实现,这样就不需要考虑内存碎片的问题,在 Arena 析构时统一释放所有内存。问题是内存只增不减,这使得这个工具只能用在一些比较有限的场景。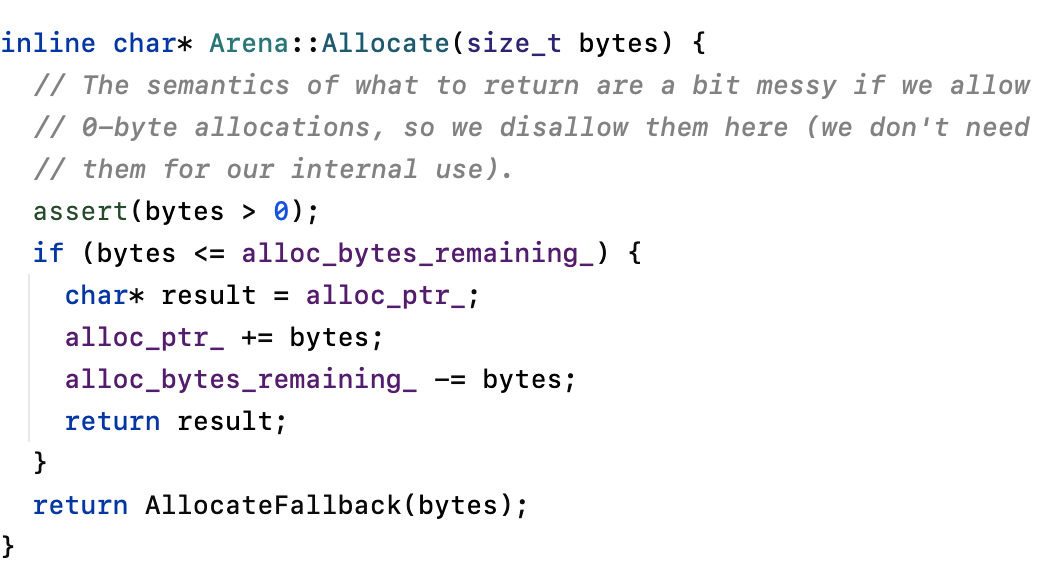
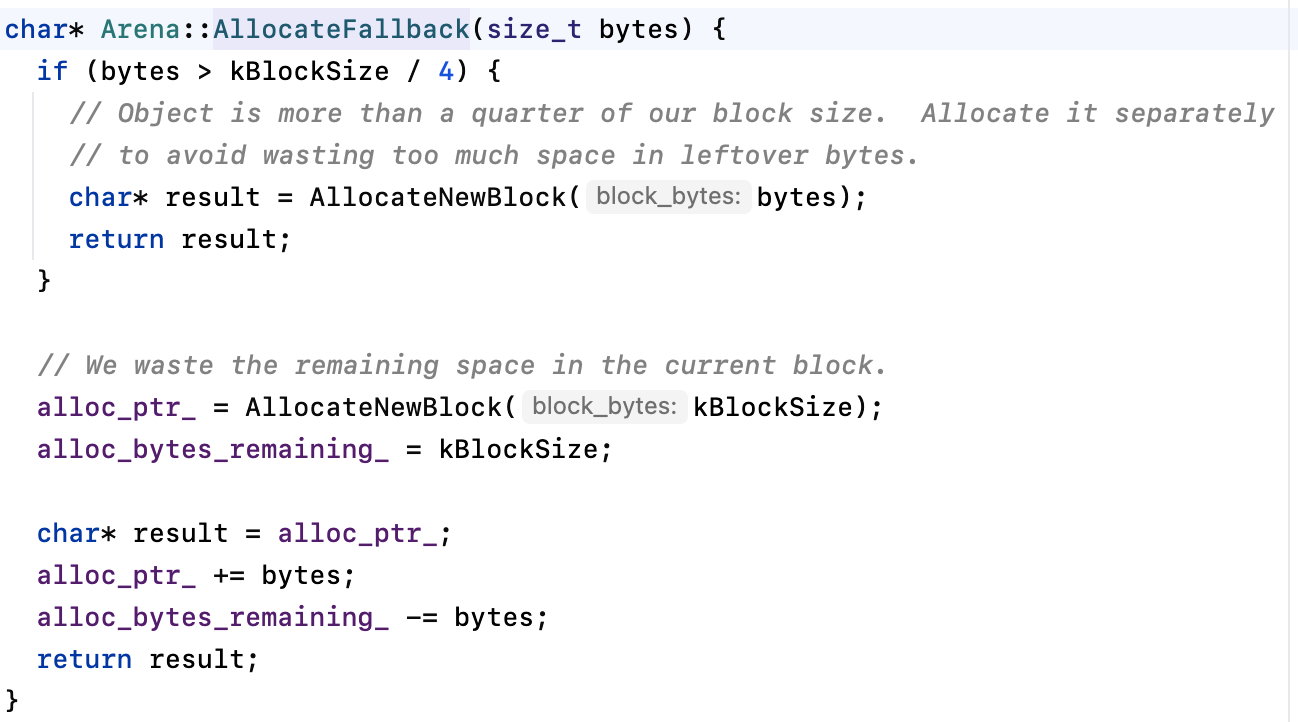
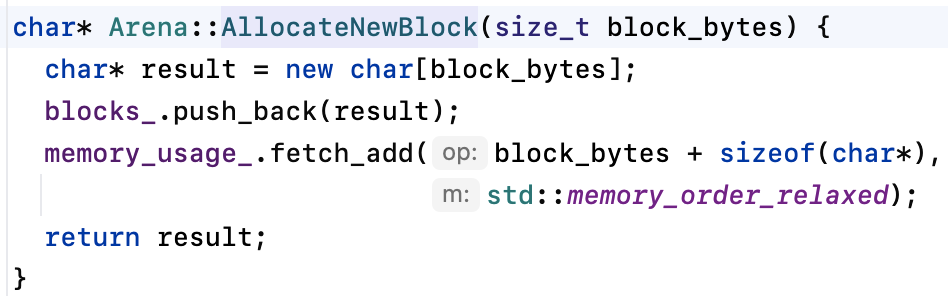
算法看起来是比较简单的,就是做一个内存块的抽象,当前块还有内存时从块中分配内存,块内存不足时则用 malloc 申请新块。相比于直接使用 malloc 申请内存,使用 Arena 申请内存在大部分情况下是无锁的(只有 atomic 操作)。
VarInt Codec
LevelDB 在编码一个 var int 时,每个字节只使用前 7 位存储数字,第 8 位则用来表示这个字节之后是否还有字节,这样 var int 的大小就可以根据其实际占用的位数来定,原本需要花费 4 个字节表示的数字可能只需要 1 个字节就可以表示。
这个做法省了空间,不过对于数字后续可能需要修改的情况是不适用的。但 LevelDB 中所有东西都是 immutable 的,所以不需要担心这个问题。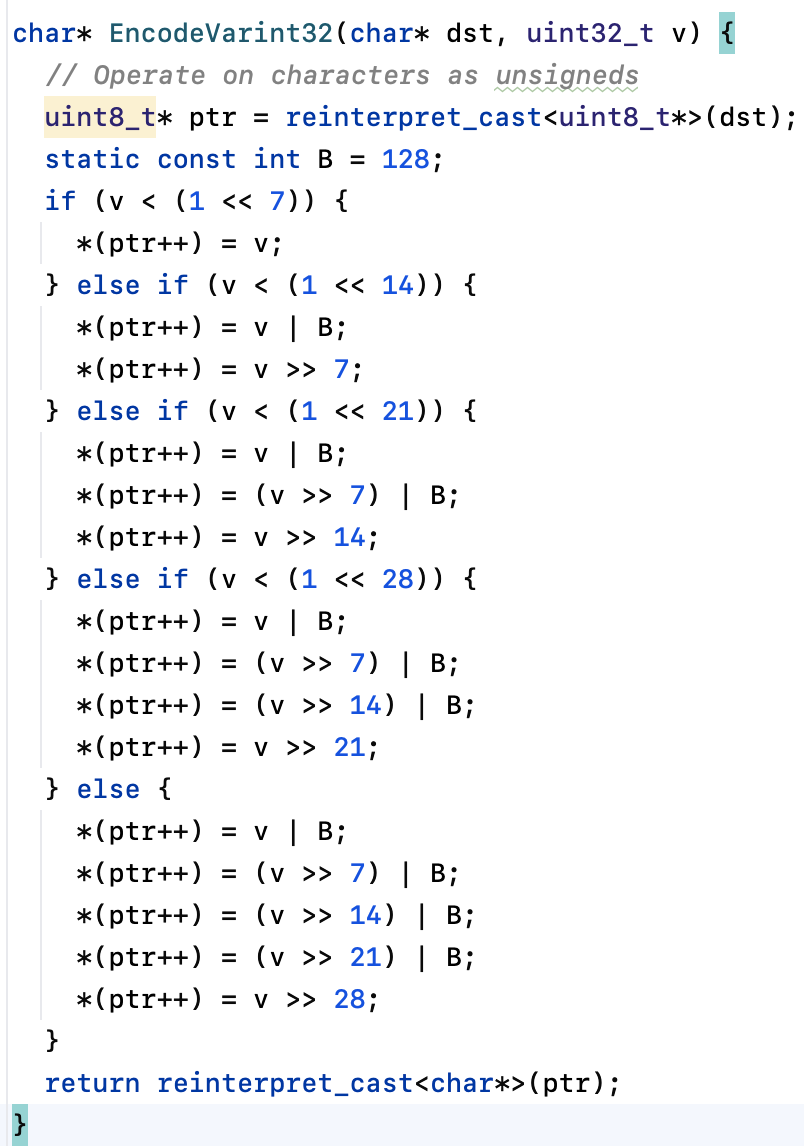
Group Commit
LevelDB 使用了组提交优化,如果在调用 DB::Write 时传入了 batch 参数,则 LevelDB 会默认将该次写入延迟一秒。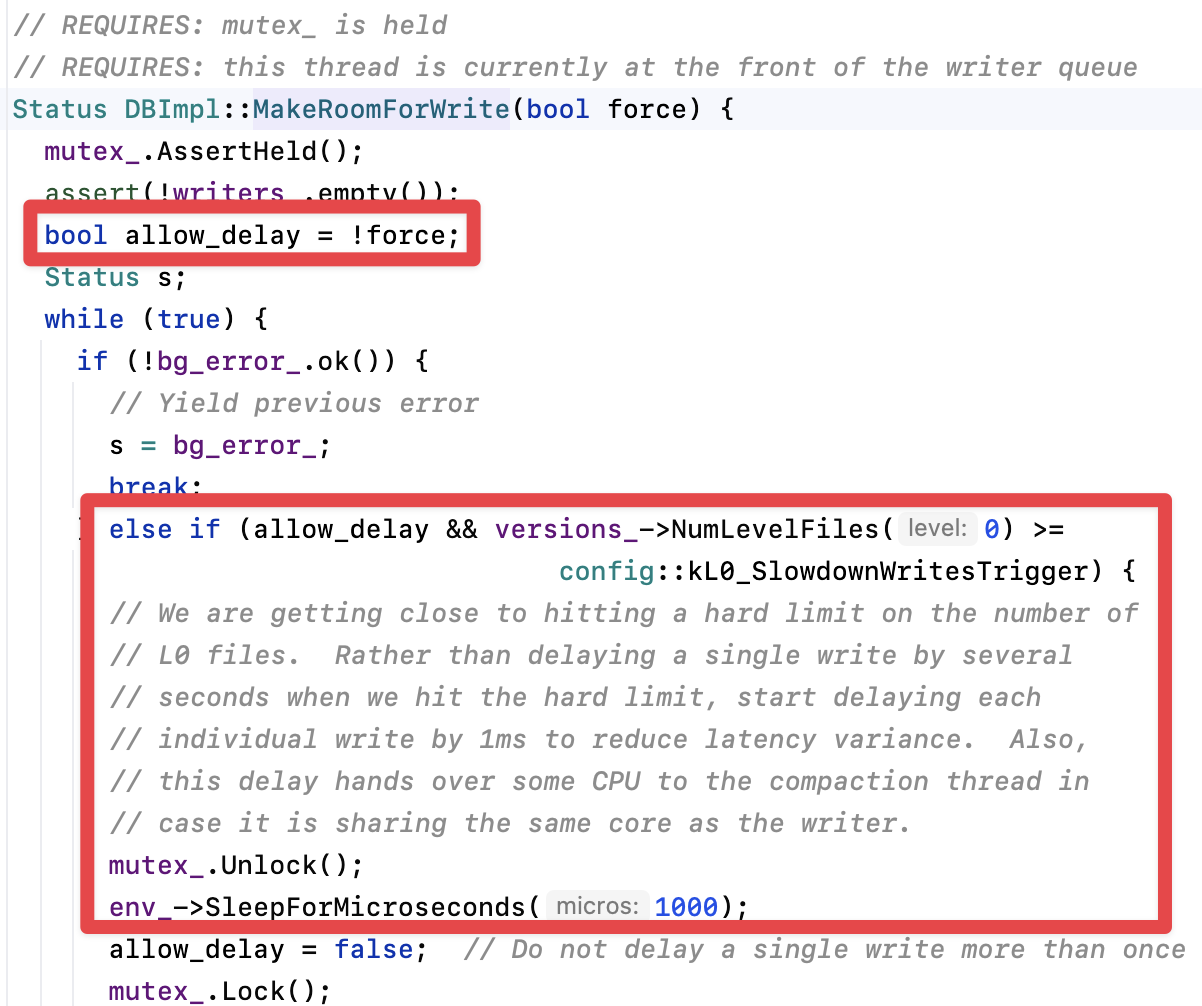
延迟期间的写入不会堵塞,而是会被写入到队列中,最后被 first write 一同写入 memtable。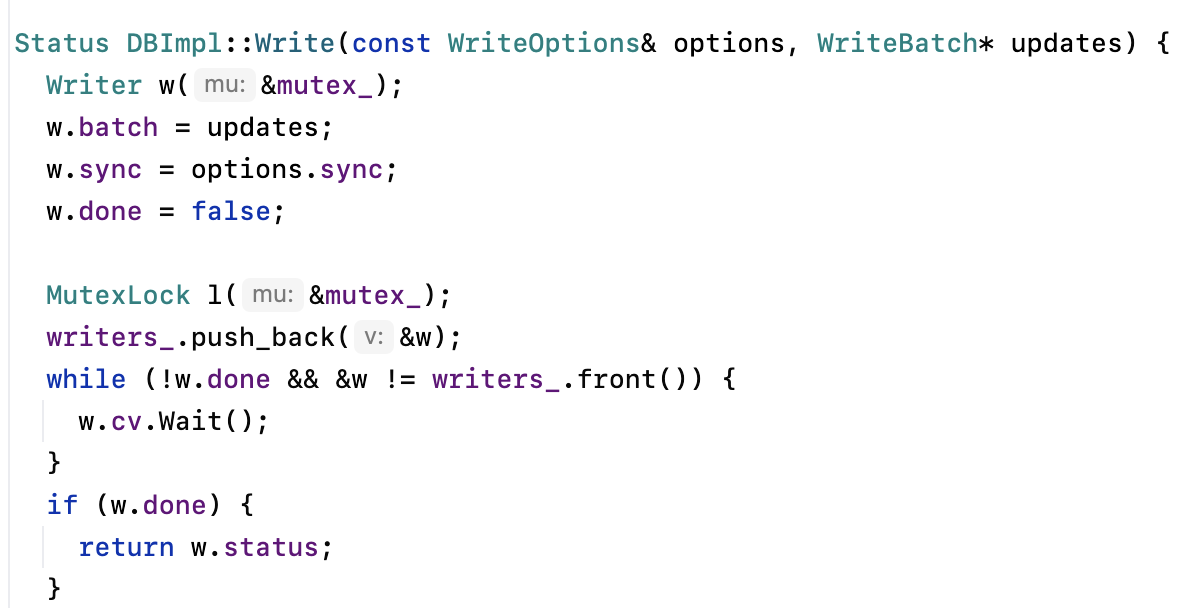
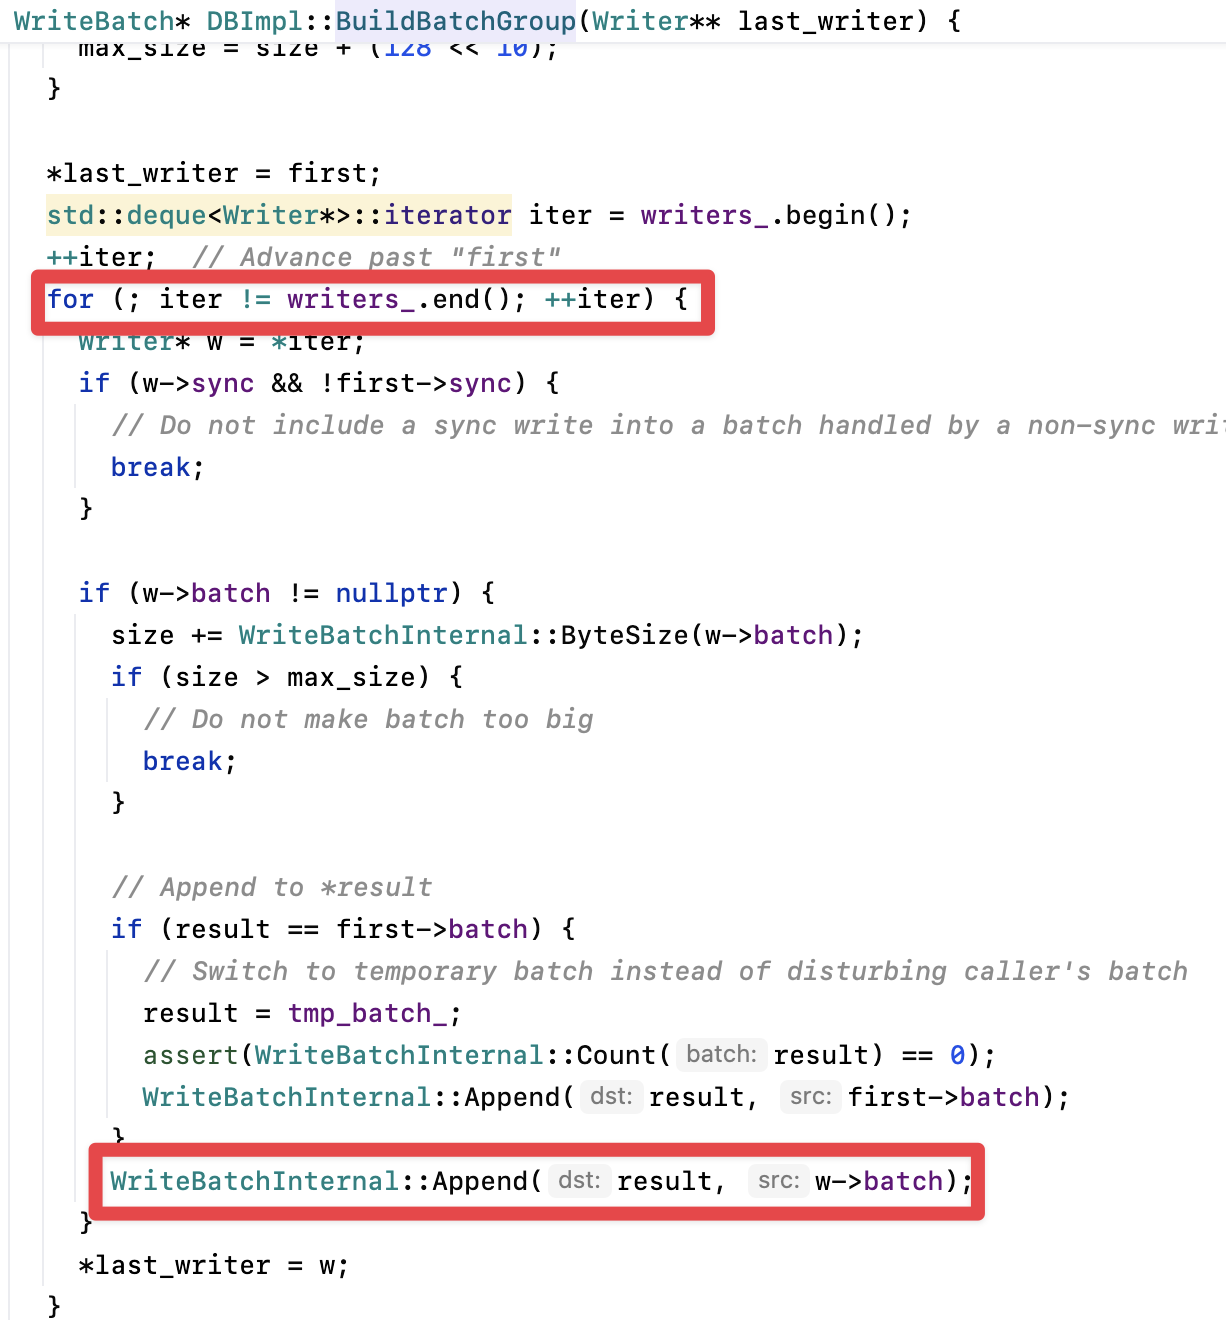
这样做有两个好处:
在 memtable 空间不够的情况下不需要停写,可以先写进 buffer 再等到 memtable freeze 完成开新 memtable 再一起提交
将多个单次写入操作合并为单个批量写操作,减少 IO 次数,提高性能。