本文是《Attention is all you need》个人阅读笔记
这篇论文主要提出了 Transformer 架构,自注意力机制,并将其运用于翻译任务,取得了不错的效果。
Transfomer 架构
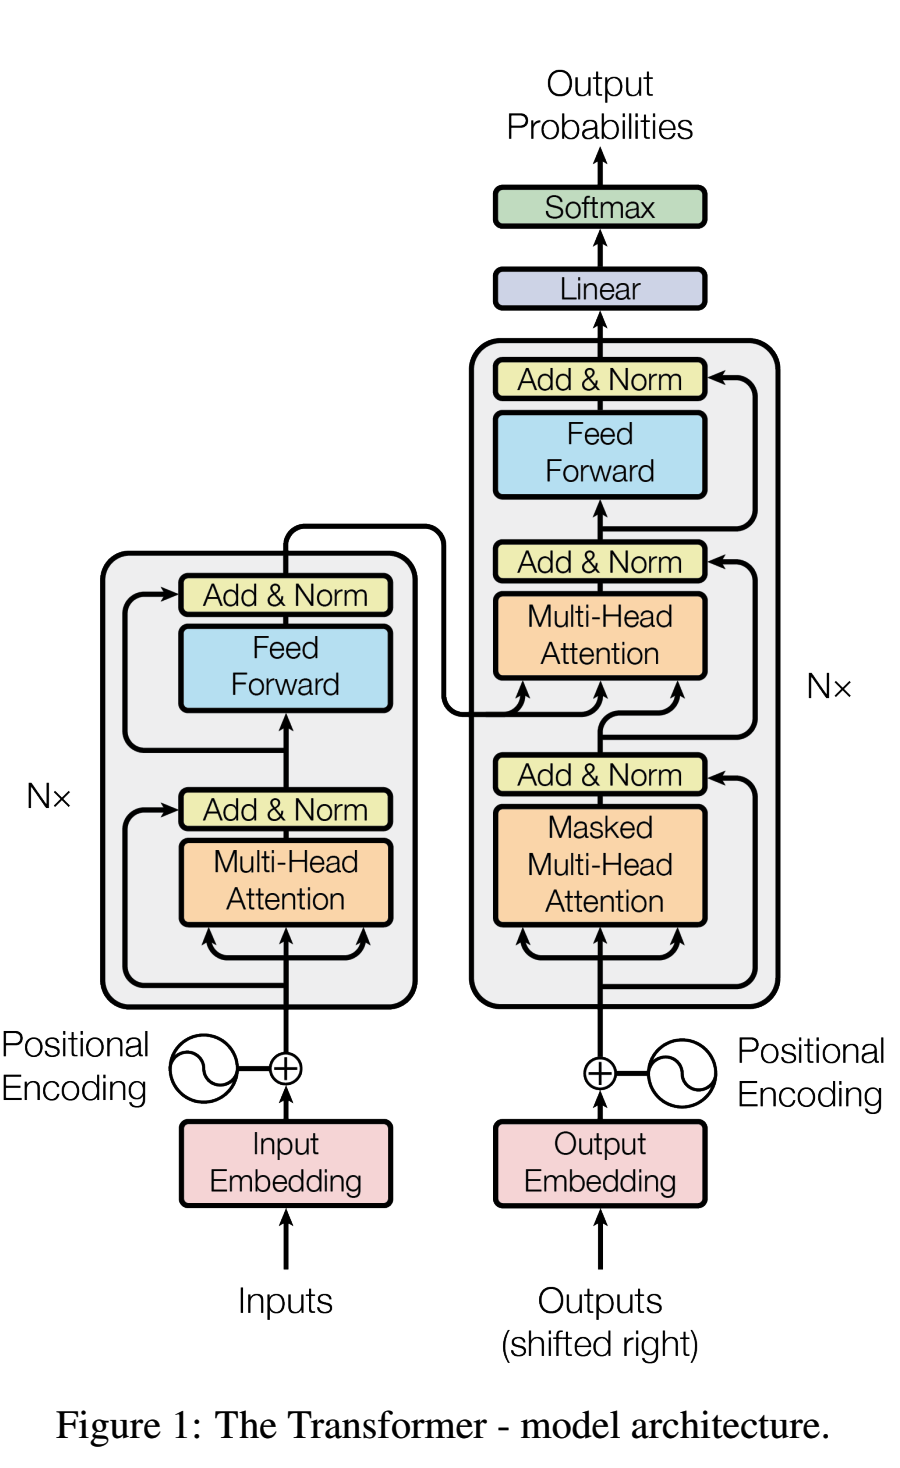
论文中提出的 Transformer 架构是 Encoder-Decoder 类型的(GPT 是 Decoder-Only)。
左侧是 Encoder 部分,负责将翻译任务的输入进行编码:
首先先分词
通过查表将 token 编码成矩阵
将 token 位置信息一起编码到矩阵(正弦位置编码)
重复6次
- 将矩阵 fork 三份,分别叫 Q K V 传给 MHA,得到当前输入token之间语义关系矩阵
- 残差相加,LayerNorm归一化
- 再经过 FFN 将特征进行非线性变换
- 残差相加,LayerNorm归一化
- 将矩阵 fork 三份,分别叫 Q K V 传给 MHA,得到当前输入token之间语义关系矩阵
输出给右侧 Decoder 的交叉注意力作为 K V
右侧是 Decoder 部分,负责将翻译任务的输出进行编码,因为输出是一个 token 一个 token 的进行输出,所以需要反复执行很多遍,发送变化的只有 Decoder 的输入,也就是累积的输出:
先分词
通过查表将 token 编码成矩阵
将 token 位置信息一起编码到矩阵(正弦位置编码)
重复6次(6层)
- 先过一遍自注意力
- 残差相加,LayerNorm归一化
- 再过一遍交叉注意力(Q 来自 Encoder,K V 来自 Decoder)
- 残差相加,LayerNorm归一化
- 再经过 FFN 将特征进行非线形变换
- 残差相加,LayerNorm归一化
- 先过一遍自注意力
再过一层线形层将 512 维的矩阵解码成每个 token 的 logits 矩阵
最后再通过 softmax 将其概率化
最后选择概率最高的token进行输出
Attention
Scaled Dot-Product Attention
$$
Attention(Q,K,V)=softmax(\frac{QK^T}{\sqrt{d_k}})V
$$
最经典的一款,原教旨注意力。
Q 表示所有位置的查询向量按行组成的矩阵
K 则是被 Q 查询的特征矩阵
V 则表示各位置实际提供的信息
Q 和 K 的点积,即 Q 乘 K 的转置,可以得到一个 Q 所有 token 对 K 所有 token 的匹配分数矩阵,把它们做softmax 就能得到一个归一化,概率化的匹配分数矩阵。
不过在 softmax 之前需要先除去一个点积的标准差 $$
\sqrt{d_k}
$$
进行缩放,防止点积导致分数差距很大,进而导致梯度太小,难以训练,防止梯度消失问题。
再拿这个匹配分数矩阵乘以 V,就得到了预测集。
Multi-Head Attention
$$
\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \text{head}_2, \dots, \text{head}_h) W^O
$$
$$
\text{head}_i = \text{Attention}(Q W_i^Q,; K W_i^K,; V W_i^V) = \text{softmax}\left(\frac{(Q W_i^Q)(K W_i^K)^T}{\sqrt{d_k}}\right) V W_i^V
$$
多头注意力就是在经典的缩放点积注意力的基础上拆分成了多个头,分头计算,分头进行合并,最后算出来在数学上跟缩放点积注意力的结果是一致。
多头注意力主要解决了以下几个问题:
并行计算:一张卡的显存不足以放下整个矩阵,所以拆成多个头,拆分到多张卡上进行计算。
避免注意力权重被稀释:如果只有一个注意力头,所有信息必须挤在同一套 Softmax 权重分布里做加权平均——要么权重全被某一种强关系抢走,要么多种关系平均之后变得模糊不清。
- 通过 $$
h$$
组不同的线性投影,让不同的头各自负责不同子空间,有的头专心找“指代对象”,有的头关注“主谓修饰”,有的头捕捉“局部邻近词”,互不干扰。
- 通过 $$
避免单一特征空间匹配标准固定:缩放点积注意力本身没有可学习参数,如果只用一套投影矩阵计算 $$
Q、K、V$$
,相当于只用一种固定标准去衡量词与词之间的相关性。- 为每个头分配独立的投影矩阵($$
W_i^Q, W_i^K, W_i^V$$
),相当于让模型学会**用 $$
h$$
** 种不同的角度去“提问”和“匹配”,最后再通过 $$
W^O$$
把多视角的提取结果融合成一个更全面的特征向量。
- 为每个头分配独立的投影矩阵($$
Positional Encoding
由于自注意力是全局同时计算所有词的两两相关性,模型是分不清词的顺序的。所以需要在 token embeding 的基础上对位置进行编码。
$$
X = E_{\text{token}} + PE
$$
正余弦位置编码
$$
PE_{(pos,, 2i)} = \sin\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right)
$$
$$
PE_{(pos,, 2i+1)} = \cos\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right)
$$
使用三角函数正弦余弦函数的方式进行位置编码,这样做主要有两个小巧思:
将值限制在 [-1, 1] 的区间范围上,防止数值太大淹没 token embeding 中 token 本身的语义。
能用线性变换表示相对位置
- $$
\begin{pmatrix} \sin(\omega(pos+k)) \ \cos(\omega(pos+k)) \end{pmatrix} = \begin{pmatrix} \cos(\omega k) & \sin(\omega k) \ -\sin(\omega k) & \cos(\omega k) \end{pmatrix} \begin{pmatrix} \sin(\omega pos) \ \cos(\omega pos) \end{pmatrix}
$$
- $$
ROPE
RoPE 是目前几乎所有主流大语言模型都在使用的位置编码方案。
假设 Query 向量 $$
q$$
在位置 $$
m$$
,Key 向量 $$
k$$
在位置 $$
n$$
。RoPE 做的事情就是把它们各自乘以一个二维旋转矩阵 $$
R(m\theta)$$
和 $$
R(n\theta)$$
:
$$
R(m\theta) = \begin{pmatrix} \cos m\theta & -\sin m\theta \ \sin m\theta & \cos m\theta \end{pmatrix}
$$
旋转之后,当自注意力计算它们俩的点积时,神奇的几何性质就出现了:
$$
(R(m\theta)q)^T \big(R(n\theta)k\big) = q^T R(m\theta)^T R(n\theta) k = q^T R\big((n - m)\theta\big) k
$$
原本的绝对位置 $$
m$$
和 $$
n$$
在乘法里直接抵消成了**相对距离 $$
(n - m)$$
,也就是说:每个词只需要知道自己的绝对位置 $$
m$$
** 并旋转一次,算出来的注意力分数就天然只取决于两个词之间隔了多远。
Residual Connection
即架构图中的 Add:
$$
\text{Output} = \text{LayerNorm}\big(x + \text{Sublayer}(x)\big)
$$
这个设计的巧思是:
没有残差连接的情况,神经网络每层做一次变换,根据链式法则,顶层的误差传回第一层时,必须把中间每一层的导数连乘起来:$$
\frac{\partial \text{Loss}}{\partial x_1} = \frac{\partial \text{Loss}}{\partial x_{20}} \cdot \frac{\partial F_{19}}{\partial x_{19}} \cdots \frac{\partial F_2}{\partial x_2} \cdot \frac{\partial F_1}{\partial x_1}
$$
。如果每一层的导数都小于1,连续乘几十次后,这个信号可能就已经消失了。- 如果引入残差连接,对$$
y = x + F(x)$$
求导,会得到$$
\frac{\partial y}{\partial x} = I + \frac{\partial F(x)}{\partial x}
$$
,由于其中单位矩阵的存在,连续乘以几十次之后,信号依旧能够无损保留。
- 如果引入残差连接,对$$
注意力的本质是在做整句话中所有词 value 的加权平均
- 如果这个过程反复多次(N层),不引入残差连接的情况就会导致所有 value 最终趋同,这种情况被称作注意力塌陷。
- 在引入残差连接后,每一层的输出变成 $$
x_{l+1} = x_l + \text{Sublayer}(x_l)$$
,如果把层级全部展开:$$
x_L = \mathbf{x_0} + \text{Sublayer}_1(x_0) + \text{Sublayer}_2(x_1) + \dots + \text{Sublayer}L(x{L-1})
$$
。最后始终能保留一份原始值,保证 value 之间的差异。
- 在引入残差连接后,每一层的输出变成 $$
- 如果这个过程反复多次(N层),不引入残差连接的情况就会导致所有 value 最终趋同,这种情况被称作注意力塌陷。
Normalization
每一个部分的输出都需要靠 LayerNorm 来进行归一化,LayerNorm 其实就是算每行的平均值和方差,然后让当前值对于平均值的差距再除以一个标准差。
然后在此基础上可以加上可学习的缩放 γ 和偏置 β,让模型自己决定“归一化之后每个维度要不要放大或平移”
$$
\text{LayerNorm}(x) = \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} \odot \gamma + \beta
$$
其中 $$
\mu = \frac{1}{d}\sum_{i=1}^d x_i$$
,$$
\sigma^2 = \frac{1}{d}\sum_{i=1}^d (x_i - \mu)^2$$
。
FFN
注意:原版 Transformer 的 FFN 其实是没有门控的
Transformer 中的 FFN 本质上是一个非常简单的两层全连接网络(MLP),中间夹一个 ReLU 激活函数:
$$
\text{FFN}(x) = \max(0,; xW_1 + b_1)W_2 + b_2
$$
先升维:把维度从 $$
d_{\text{model}}$$
(如512)放大 4 倍到 $$
d_{\text{ff}}$$
(如2048)。非线性激活:通过 ReLU 过滤掉负值(只保留被激活的特征神经元)
降维($$
W_2$$
):把2048维再投影回512维。
FFN 给模型提供了 “逐特征非线性折叠” 能力,可以更好的拟合高维特征
Softmax
Softmax 是一种把任意实数向量(可正、可负、大小任意)转换成概率分布的算法——输出向量里的每个值都在 $$
(0, 1)$$
之间,且所有元素加起来严格等于 1。
$$
\text{Softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{n} e^{z_j}}
$$
在这里主要用于将 token 的 logits 矩阵概率化,最后就能得到每个token对应概率的矩阵,选择概率最高的一个即可。
另外有一个值得一提的是,LLM 的 Temperature 其实就是作用在 Softmax 算法上的。一般概率这样计算 $$
\text{Softmax}(z_i / T)$$
,这样就引入了一个可以调整的 Temperature 参数,T 越小,不同选项之间的差距被拉大,几乎把全部权重压给最大项。而 T 越大,不同选项之间的差距就会缩小,就会得到随机性和多样性更强的结果。